
Testy automatyczne w erze AI – czym jest Verification Engineering?
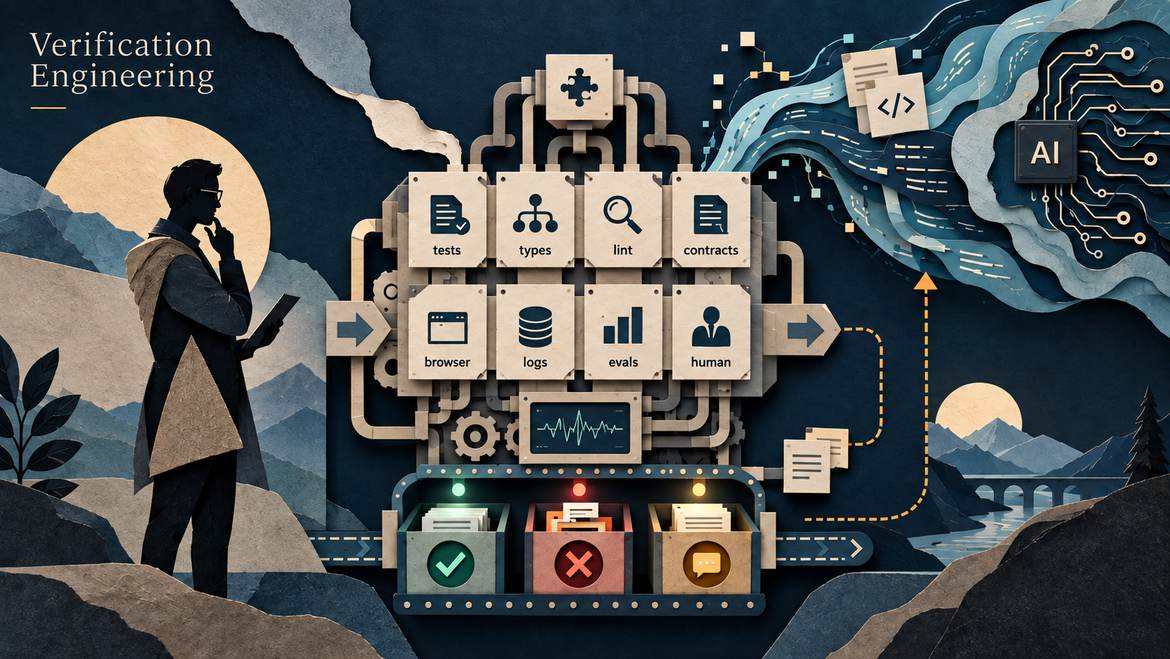
Verification Engineering to projektowanie systemu weryfikacji, który daje człowiekowi i agentowi AI szybki oraz wiarygodny sygnał o tym, czy zmiana jest poprawna. Obejmuje zarówno testy automatyczne, typy, kompilator, lint, kontrakty, analizę statyczną i sprawdzenia w runtime, jak i evals oraz ocenę człowieka.
AI potrafi dziś wygenerować kod, testy i refaktoryzację szybciej niż jeszcze rok temu. Stąd pytanie, które słyszę coraz częściej od zespołów QA:
Skoro AI pisze też testy, to czy automatyzacja testów traci na znaczeniu?
Moim zdaniem jest odwrotnie: im więcej pracy wykonuje agent, tym bardziej potrzebujemy mechanizmów, które szybko powiedzą nam, i samemu agentowi, czy zmiana jest poprawna. Zmienia się natomiast rola testu. Z końcowej kontroli staje się bowiem sygnałem, który steruje pracą AI:
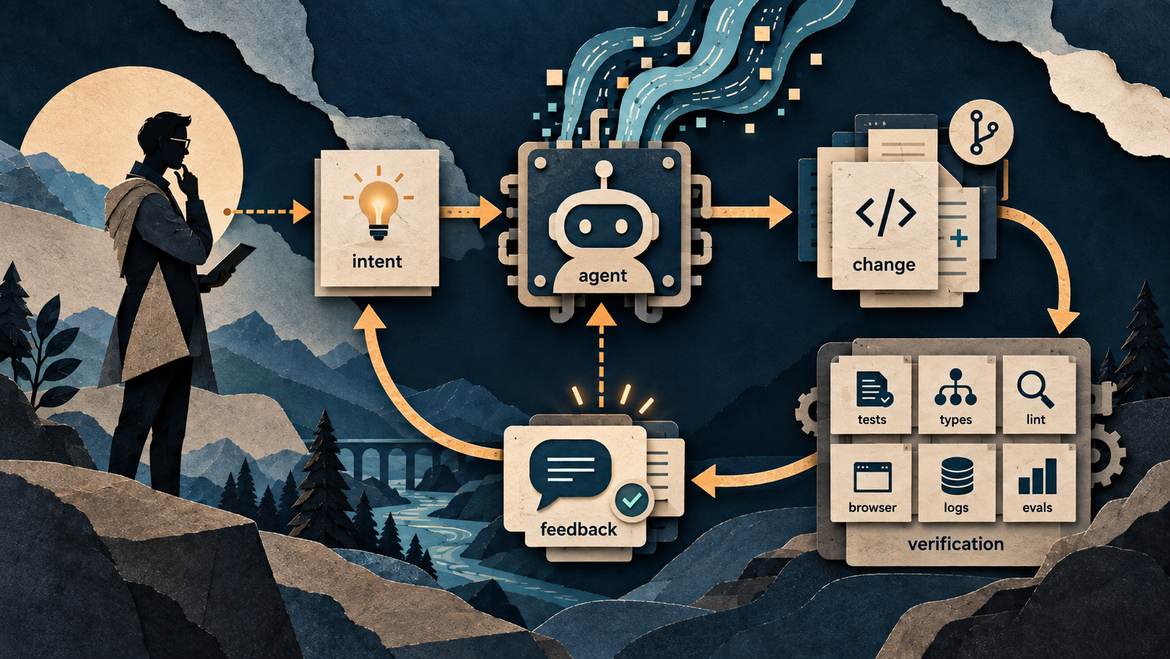
intencja człowieka -> agent -> zmiana -> automatyczna weryfikacja -> feedback -> poprawka
Tę szerszą perspektywę nazywam w artykule Verification Engineering, choć sam termin nie jest nowy. Od dekad funkcjonuje bowiem w systems engineering i przy weryfikacji układów scalonych, gdzie oznacza wykazanie zgodności systemu ze specyfikacją. W kontekście agentów AI dopiero się kształtuje i nie ma jednej kanonicznej definicji ani statusu oficjalnej metodyki. Traktuję go jako ramę, która łączy kilka kierunków rozwijanych dziś równolegle przez ludzi takich jak Kent Beck, Simon Willison, Mitchell Hashimoto czy Birgitta Böckeler: TDD w pracy z agentami, harness engineering, agentic manual testing, testy jednorazowe i evals.
Czego dowiesz się z tego artykułu
- dlaczego AI nie zmniejsza potrzeby testów automatycznych, ale zmienia ich miejsce w procesie,
- czym jest harness i dlaczego bywa skuteczniejszy niż kolejna reguła w prompcie,
- dlaczego test oracle staje się najdroższym elementem testu,
- kiedy test warto napisać, choć nie warto go utrzymywać,
- jak powiązać poziom autonomii agenta z jakością weryfikacji w projekcie,
- jak zacząć bez budowania wielkiej platformy (checklista 8 pytań).
Tekst jest kontynuacją dwóch wcześniejszych artykułów: w Piramidzie testów 2.0 pisałem, że AI nie obala klasycznej piramidy, tylko zwiększa wartość szybkich testów niskiego poziomu [14]. Natomiast w Modelach dojrzałości AI wniosek był podobny na poziomie organizacji: dojrzałość to środowisko, w którym narzędzi AI można używać bezpiecznie i powtarzalnie [15]. Ten artykuł jest kolejnym krokiem: jak zaprojektować system, dzięki któremu człowiek i AI szybko dowiedzą się, czy zmiana jest naprawdę poprawna.
Jeśli chcesz praktycznie rozwijać umiejętności związane z AI w testowaniu, sprawdź też AI_Testers (aitesters.pl) – program przygotowany z myślą o wykorzystaniu AI w pracy testerów, automatyzacji i nowoczesnym podejściu do jakości [16].
Dlaczego AI nie zmniejsza potrzeby testów automatycznych
AI zmienia ekonomię tworzenia software’u: developer szybciej generuje implementację, a tester szybciej tworzy scenariusze. Agent potrafi natomiast zmodyfikować kilkanaście plików, poprawić testy, zaktualizować dokumentację, uruchomić pipeline i iterować nad znalezionymi błędami.
Szybsze generowanie kodu nie oznacza jednak lepszego kodu. Jeśli rośnie liczba zmian, rośnie też liczba rzeczy, które trzeba zweryfikować.
Simon Willison zwraca uwagę, że dobry zestaw testów automatycznych znacząco zmniejsza ryzyko błędów w pracy z LLM-ami [1]. Model może bowiem przygotować dużą zmianę, a istniejący test suite natychmiast pokazuje, czy naruszone zostało znane zachowanie systemu. Podobnie wygląda to w eksperymencie OpenAI, gdzie zespół budował produkt głównie za pomocą narzędzia Codex [3]. Praca człowieka polegała tam w mniejszym stopniu na pisaniu kodu, a w większym na projektowaniu środowiska, definiowaniu intencji i budowaniu pętli feedbacku, dzięki którym agent pracował bardziej niezawodnie.
Najważniejsza zmiana nie brzmi więc “AI napisze za nas testy”, tylko:
AI może wykonywać więcej pracy, jeżeli stworzymy środowisko, które szybko pokaże mu, kiedy się myli.
Test przestaje być tylko sprawdzeniem
Klasyczny przepływ można uprościć do schematu: programista -> kod -> test -> wynik. Test był zatem mechanizmem sprawdzającym gotową zmianę.
W pracy z agentami przepływ wygląda inaczej: człowiek definiuje intencję -> agent tworzy zmianę -> system ją sprawdza -> agent reaguje na wynik -> kolejna próba -> człowiek ocenia rezultat i ryzyko.
Tym samym test przestaje być końcową kontrolą, a staje się źródłem informacji dla agenta. Ten sam test, który wcześniej służył programiście, testerowi albo pipeline’owi CI, jest teraz również formą komunikacji z maszyną – mówi “to zachowanie jest poprawne” albo “coś poszło źle, spróbuj jeszcze raz”.
Dlatego praktycy pracujący intensywnie z agentami dochodzą z różnych stron do podobnego wniosku:
Sam agent nie wystarczy, potrzebuje bowiem środowiska, które dostarcza mu wiarygodnego feedbacku.
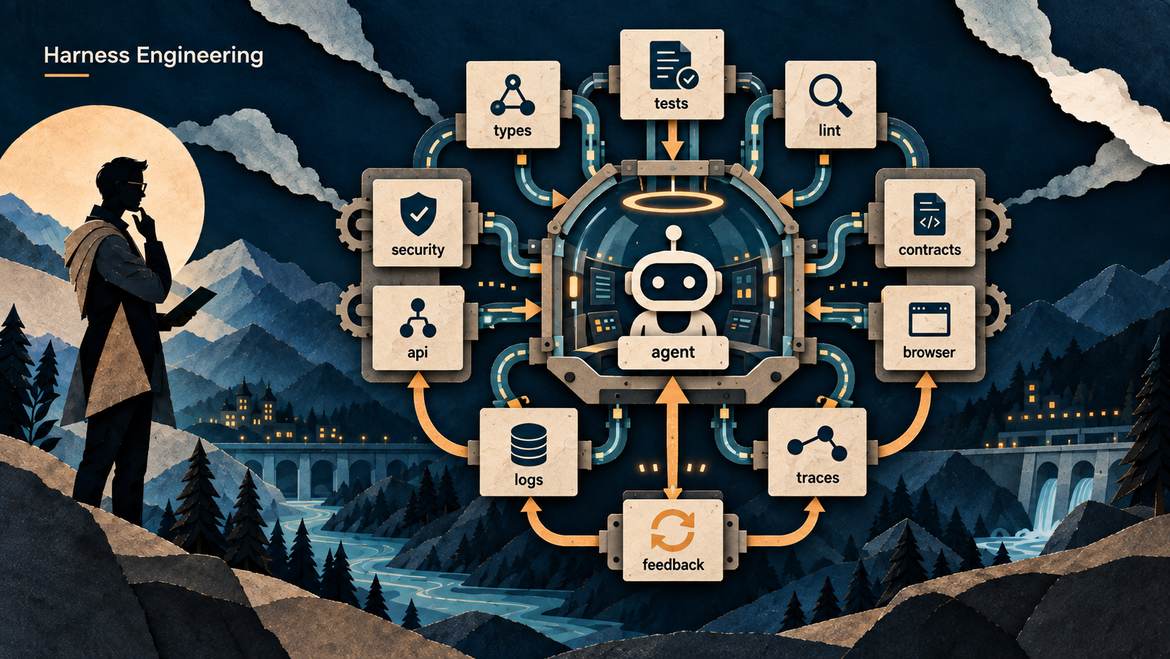
Dobry prompt to za mało: harness engineering dla agentów AI
Przy pracy z AI łatwo wpaść w nawyk naprawiania każdego problemu kolejną instrukcją. Agent użył złego API, więc dopisujemy zasadę do AGENTS.md. Nie uruchomił testów, więc dodajemy “zawsze uruchamiaj testy”. Naruszył architekturę, więc opisujemy ją jeszcze dokładniej.
To wszystko może pomagać, istnieje jednak drugi sposób myślenia. Zamiast mówić agentowi “nie rób tego”, możemy zapytać:
Jak zbudować środowisko, które automatycznie wykryje, że agent właśnie zrobił coś źle?
Mitchell Hashimoto nazywa takie podejście harness engineering [2]. Gdy agent regularnie popełnia określony błąd, warto stworzyć szybki mechanizm, który ten błąd wykrywa. Może to być na przykład test, type checker, linter, kompilator, dodatkowe narzędzie albo inna automatyczna forma walidacji.
Harness w praktyce: reguła lint zamiast zakazu w prompcie
Prosty przykład z projektu z testami napisanymi w Playwright.
Agent uparcie wstawia do testów page.waitForTimeout(). Możemy dopisać zakaz do promptu i liczyć, że model go zapamięta, albo dodać regułę ESLint, która blokuje to wywołanie. Dzięki temu agent dostaje błąd w sekundę, sam go czyta i sam poprawia. Nie poprawiamy promptu, tylko środowisko pracy agenta.
- kompilacja i typy: compiler, type checker,
- testy: unit, testy API, kontrakty, architecture tests,
- analiza statyczna i bezpieczeństwo: lint, static analysis, security checks,
- runtime: dostęp do uruchomionej aplikacji, przeglądarka, screenshoty, logi, traces,
- dane i skrypty: test data, skrypty walidacyjne.
Harness nie jest jednym produktem, tylko raczej środowiskiem, które pozwala agentowi wykonać pracę i sprawdzić jej rezultat.
Od automatyzacji testów do Verification Engineering
Automatyzacja testów zaczyna opisywać coraz mniejszą część problemu. Jeśli agent może sam napisać kod i test, uruchomić go, skompilować projekt, otworzyć aplikację, wykonać request, sprawdzić logi i screenshot, przeanalizować błąd i poprawić implementację, to naszym zadaniem nie jest już dostarczenie kolejnego testu.
Musimy zatem zaprojektować cały feedback loop, w którym test jest jednym z elementów. To właśnie ta zmiana perspektywy kryje się pod nazwą Verification Engineering.
W skrócie kiedy agent powtarza błąd, nie dopisuj kolejnej reguły do promptu, tylko dodaj mechanizm, który ten błąd wykryje automatycznie.
Zielone testy to nie koniec weryfikacji: agentic manual testing
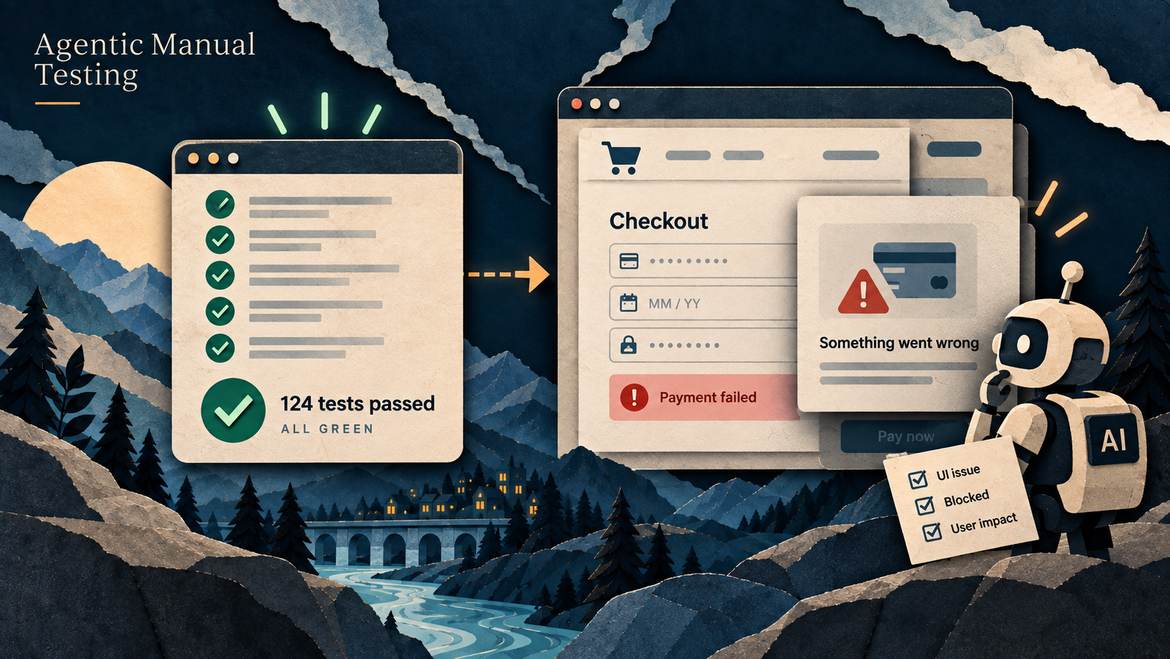
Załóżmy, że agent zmodyfikował frontend. Następnie uruchamia npm test, widzi 124 tests passed i uznaje zadanie za zakończone.
Tylko że aplikacja może nadal nie działać: może się nie uruchamiać albo mieć niewidoczny przycisk. API może natomiast zwracać prawidłowe dane, których UI nie wyświetla. Możemy też zwyczajnie nie mieć testu na dany problem.
Simon Willison opisuje dlatego podejście nazwane agentic manual testing [4]. Agent nie ogranicza się do uruchomienia test suite, bo może na przykład uruchomić aplikację, wykonać request przez curl, wejść na stronę przez rzeglądarkę, przejść flow użytkownika, obejrzeć screenshot, przejrzeć logi i sprawdzić kilka edge case’ów. Jeśli znajdzie problem, odtwarza go jako failing regression test, poprawia implementację i doprowadza test do zielonego.
W praktyce może to wyglądać tak, że agent z dostępem do przeglądarki, na przykład przez Playwright MCP, przechodzi raz flow “dodaj do koszyka -> checkout”. Następnie robi screenshot i widzi, że przycisk “Zapłać” jest zasłonięty przez stopkę na małym ekranie. Znajduje w ten sposób błąd, którego 124 unit testy nie mogły złapać. Ten jeden problem trafia potem do repozytorium jako pojedynczy test regresji, a nie jako kolejny wielki scenariusz E2E.
Stąd ważne rozróżnienie:
Automated test suite to nie to samo co pełna weryfikacja.
Agent powinien mieć możliwość rzeczywiście użyć produktu, który właśnie zmodyfikował.
Agentic verification nie oznacza tysiąca testów E2E
Tu łatwo jednak przesadzić w drugą stronę. Skoro agent potrafi używać przeglądarki, możemy przecież automatycznie przechodzić setki flow użytkownika. Tylko czy wszystkie powinny trafić do CI jako stałe testy E2E?
David Heinemeier Hansson od lat krytykuje rozbudowane portfolio testów systemowych i browserowych ze względu na ich koszt, czas wykonania, niestabilność testów i fałszywe alarmy [12]. AI nie usuwa jednak tych problemów. Może obniżyć koszt utrzymania części testów, ale nadal zostają czas wykonania testów i pipeline’u, infrastruktura, szum, trudniejsza diagnoza i liczba zależności potrzebnych do przeprowadzenia scenariusza.
Agentic browser verification to nie to samo co stały browser test w CI.
Agent może przejść konkretny flow raz, żeby zdobyć informację. Nie oznacza to, że ten sam flow powinien być wykonywany przy każdym pull requeście przez kolejne pięć lat.
W skrócie: zielony test suite mówi tylko tyle, że nie zepsuliśmy tego, co już sprawdzamy.
Nie każdy test musi żyć wiecznie: testy jednorazowe w pracy z AI
Przez wiele lat przy automatyzacji zadawaliśmy pytanie:
czy warto ten test utrzymywać?
I słusznie, bo jeśli jego napisanie zajmuje godzinę, a potem przez trzy lata trzeba go naprawiać razem ze zmieniającą się aplikacją, test musi dostarczać długoterminowej wartości.
Przy testach jednorazowych rachunek wygląda natomiast inaczej. Załóżmy na przykład, że mamy hipotezę dotyczącą wydajności albo nietypowego zachowania API. Możemy poprosić agenta:
- wygeneruj test,
- przygotuj potrzebne dane,
- uruchom kilka wariantów,
- porównaj wyniki,
- wyciągnij wniosek.
A potem usunąć wygenerowany kod. Test zrobił dokładnie to, czego od niego potrzebowaliśmy: dostarczył informację i nie musi zatem trafić do CI, zostać w repozytorium ani być utrzymywany.
A konkretnie: chcemy sprawdzić, czy nowa implementacja endpointu wyszukiwania jest szybsza od starej. Agent generuje skrypt k6 albo prostą pętlę 200 requestów, następnie uruchamia go na obu wersjach, wkleja porównanie czasów jako komentarz do PR i kasuje skrypt. Nikt nie będzie tego utrzymywał, bo nie ma czego.
Theo Browne zwraca uwagę na potencjał generowania przez AI dużej ilości tymczasowego kodu, który służy wyłącznie do weryfikacji ważniejszego kodu – testów, instrumentacji, własnych checkerów czy eksperymentalnych narzędzi [13]. Koszt takiego eksperymentu spada, jeśli agent przygotuje go w kilka minut. Na potrzeby jednego zadania agent może na przykład wygenerować tymczasowy test, własną regułę lint, instrumentację, debug script, prosty load test, alternatywną implementację do porównania albo specjalny checker.
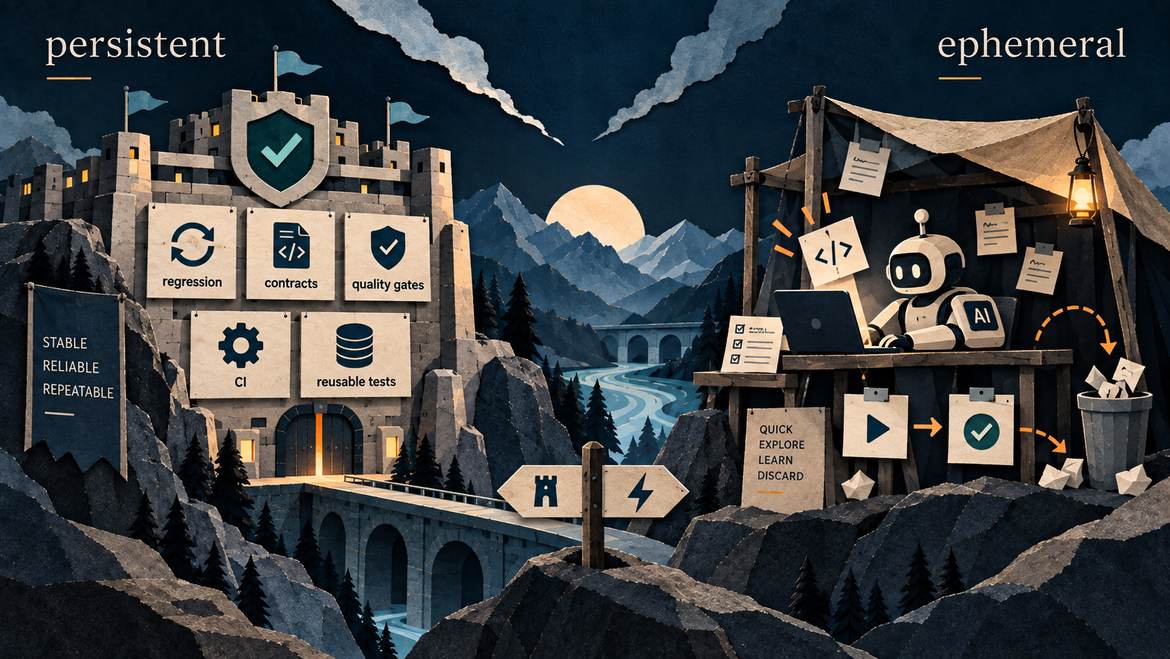
Weryfikacja trwała a jednorazowa
To daje rozróżnienie, którego klasyczna piramida testów nie opisywała:
| Weryfikacja trwała (persistent) | Weryfikacja jednorazowa (ephemeral) |
| ochrona przed regresją | diagnostyka |
| quality gate w CI | debugging |
| wykonywalna specyfikacja | eksperyment |
| kontrakt | test hipotezy |
| długoterminowe zabezpieczenie | jednorazowa informacja |
| utrzymanie | usunięcie po użyciu |
Piramida odpowiada na pytanie: na jakim poziomie systemu testujemy? AI sprawia, że ważne stają się też pytania: po co powstaje ten test i jak długo powinien istnieć?
W skrócie:
test nie musi być wart utrzymywania, żeby był wart napisania.
Więcej testów nie oznacza większej pewności: problem test oracle
Tanie generowanie testów tworzy jeszcze jeden problem. Agentowi łatwo przecież powiedzieć “dodaj więcej testów”. W efekcie może powstać kilkadziesiąt nowych przypadków. Pipeline jest “bardziej zielony”, coverage rośnie.
Tylko czy rzeczywiście wiemy więcej?
Kent C. Dodds opisuje odwrotny problem – jego agenci generowali dużo testów o niskiej wartości, więc zaczął automatycznie analizować i usuwać przypadki, które niewiele wnosiły [8]. Chodzi między innymi o drobne testy wrapperów, oczywistych wartości czy scenariuszy, których wartość nie uzasadnia kosztu ich dalszego posiadania.
Test suite oceniamy po tym, ile wnosi informacji, a nie po liczbie testów.
500 zielonych testów nie daje większej pewności niż 100, jeśli wszystkie opierają się na tym samym założeniu. Koszt napisania testu maleje. Nadal kosztuje nas jednak jego wykonywanie, zrozumienie, utrzymanie, interpretacja awarii, szum w pipeline i czas potrzebny na feedback. AI obniża koszt implementacji testu. Nie usuwa natomiast kosztu jego posiadania.
Najdroższy fragment testu przestaje być kodem
Załóżmy, że chcemy przetestować:
calculateDiscount(customer, product)
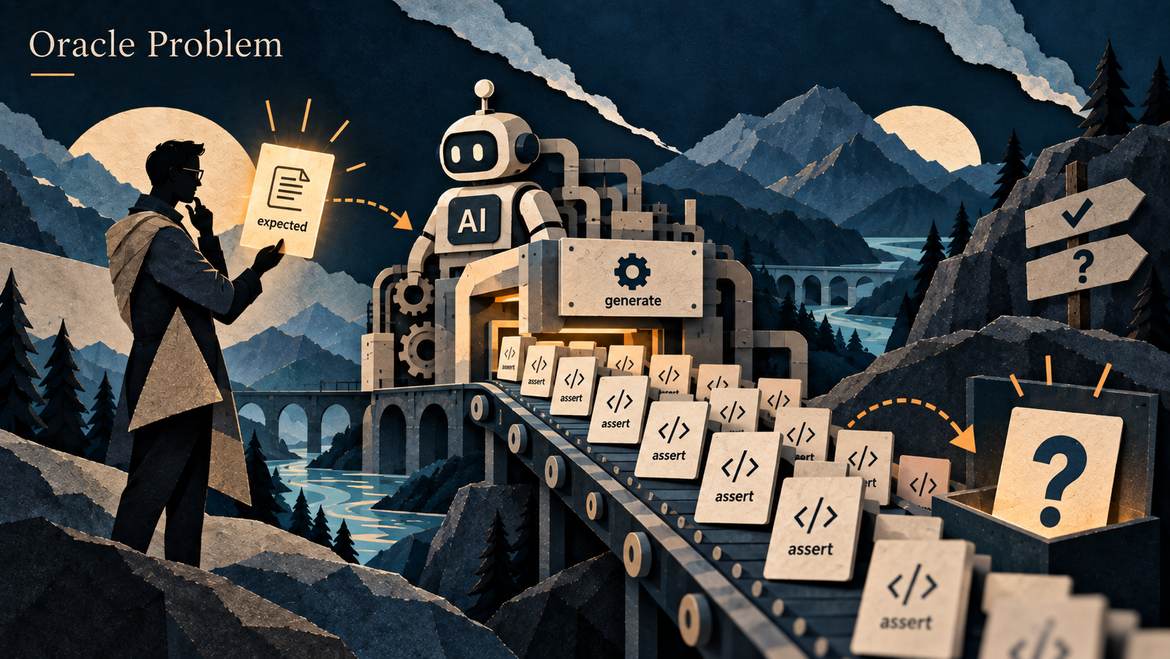
AI bez problemu wygeneruje oczywiście setup, mocki, asercje, dane testowe i warianty edge case’ów. Nadal pozostaje pytanie: jaki rabat jest prawidłowy? 5% czy 10%? Czy status VIP łączy się z promocją? Czy rabaty się sumują? Co z produktem już przecenionym? Czy pracownik ma inne zasady?
To nie jest problem składni testu, tylko problem oracle.
actual === expected, ale oracle może też wynikać z reguły biznesowej, specyfikacji, kontraktu, innego systemu referencyjnego, właściwości matematycznej albo oceny eksperta domenowego. AI szybko wygeneruje expect(result).toBe(10), znacznie trudniejsze pozostaje jednak pytanie: skąd wiemy, że 10 jest prawidłową odpowiedzią?
Podsumowując AI obniża koszt napisania asercji. Nie obniża kosztu ustalenia, jaka wartość jest poprawna.
TDD z AI wraca, ale nie jako rytuał
AI odświeżyło stary spór o TDD 😉
Kent Beck nadal używa TDD w pracy ze swoim AI stackiem [5] i ma to zresztą dużo sensu. Możemy zacząć od oczekiwane zachowanie -> test -> implementacja AI, zamiast implementacja AI -> AI generuje test do własnej implementacji.
Drugi wariant zawiera pułapkę. Wyobraźmy sobie, że AI źle zrozumiało wymaganie i przyjęło, że rabat VIP nie łączy się z promocją. Pisze zatem calculateDiscount z tym założeniem. Następnie prosimy ten sam model: “napisz testy dla swojej implementacji”. Model powiela to samo błędne założenie i generuje expect(discount).toBe(10), choć poprawna odpowiedź to 15. Otrzymujemy:
błędna implementacja + błędny test = zielony pipeline
Dlatego Dave Farley, Kent Beck czy środowisko związane ze Specification by Example wracają do starej idei oczekiwane zachowanie powinno być zdefiniowane niezależnie od implementacji. Test może napisać AI. Ale odpowiedź na pytanie “co właściwie powinno się wydarzyć?” nie powinna wynikać wyłącznie z istniejącego kodu.
Red-Green-Refactor nie musi być świętym rytuałem dla agenta
Birgitta Böckeler przeprowadziła niewielki eksperyment porównujący agentów pracujących z narzuconym TDD i bez niego [6]. Wymuszony cykl Red-Green-Refactor nie dał przy tym lepszych rezultatów, a zużył kilkakrotnie więcej tokenów – od około 3× przy zadaniach średnich do 8,5× przy małych. Autorka zaznacza ograniczenia eksperymentu i traktuje te mnożniki orientacyjnie, ale koszt jest wymierny.
Czasami próbujemy zmusić maszynę do odwzorowania procesu stworzonego dla człowieka. A cele TDD są ważniejsze niż rytuał: sprecyzowanie zachowania, szybki feedback, ochrona przed regresją, projektowanie sensownego API i ograniczenie overengineeringu.
W pracy z agentem większą wartość ma prawdopodobnie intencja test-first niż perfekcyjnie odegrane przez AI Red -> Green -> Refactor. Warto zastanowić się, które elementy TDD są mechaniką pracy człowieka, a które realną wartością dla jakości systemu.
W skrócie ważniejsze od rytuału Red-Green-Refactor jest zdefiniowanie oczekiwanego zachowania niezależnie od implementacji.
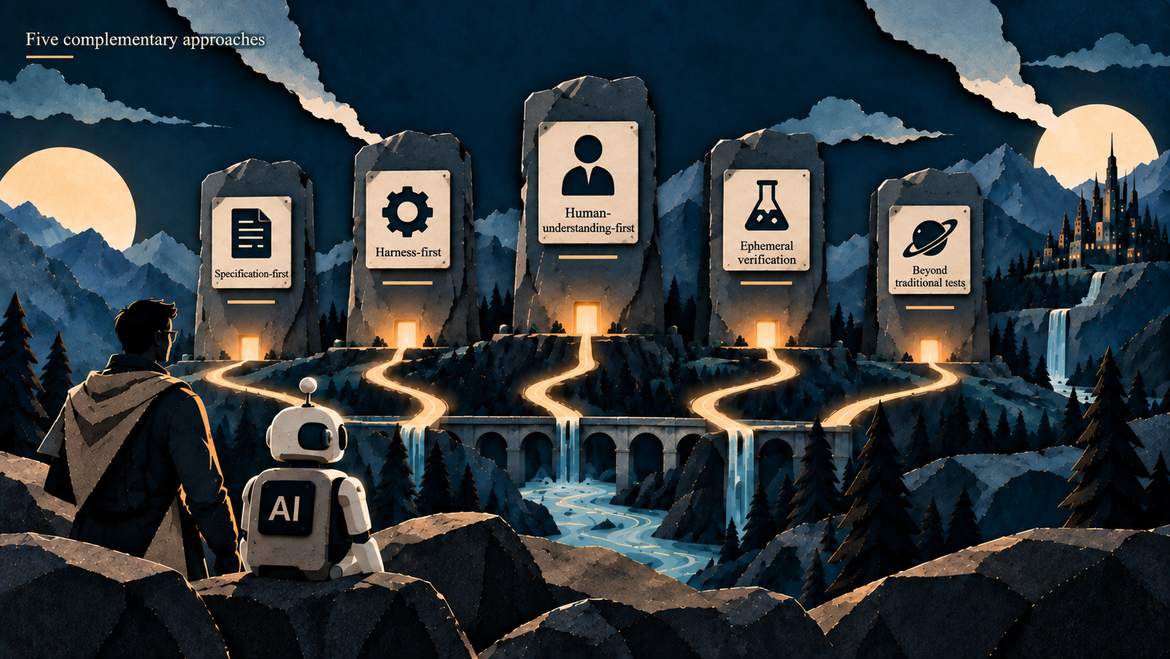
Pięć podejść do testowania z AI, które się uzupełniają
Po przejrzeniu różnych praktyk widać, że nie powstała jedna nowa metodyka pod tytułem “AI Testing Methodology 2026”. I dobrze. Zamiast tego istnieją różne podejścia odpowiadające na różne problemy. Najpierw pełniejsza mapa, potem jej uproszczenie do pięciu perspektyw.
| Podejście | Główne pytanie | Rola AI | Rola człowieka |
| TDD / test-first | Co system powinien zrobić? | generuje testy i implementację, iteruje | określa zachowanie, kontroluje oracle |
| BDD / Specification by Example | Jak wygląda poprawne zachowanie na konkretnych przykładach? | zamienia przykłady w kod i testy | dostarcza kontekst domenowy i właściwe przykłady |
| Risk-based testing | Co najbardziej opłaca się sprawdzić? | analizuje zmiany i proponuje scenariusze | ocenia ryzyko i priorytety |
| Regression automation | Czy zepsuliśmy znane zachowanie? | tworzy, wykonuje i może utrzymywać testy | decyduje, które zabezpieczenia są warte posiadania |
| Harness engineering | Skąd agent wie, że zrobił coś źle? | korzysta z testów, narzędzi i automatycznego feedbacku | projektuje środowisko i guardrails |
| Agentic manual testing | Czy rozwiązanie naprawdę działa po uruchomieniu? | używa aplikacji, przeglądarki, API, CLI, logów | określa granice i ocenia wynik |
| Ephemeral verification | Jak szybko sprawdzić hipotezę? | generuje tymczasowy test, skrypt lub eksperyment | formułuje problem i interpretuje wynik |
| AI evals | Czy niedeterministyczny system zachowuje się wystarczająco dobrze? | wykonuje przypadki, może wspierać ocenę | definiuje kryteria jakości i analizuje failure modes |
| Property-based / formal verification | Jakie właściwości muszą być zawsze prawdziwe? | pomaga generować przypadki, właściwości i dowody | definiuje invariants i wymagane gwarancje |
Jeśli uprościmy tę mapę, zostaje pięć szerszych perspektyw.
1. Specification-first
Kent Beck, Dave Farley i praktycy Specification by Example. Główna idea: najpierw ustalmy, czego oczekujemy, dopiero potem pozwólmy AI stworzyć rozwiązanie. Schemat: intencja -> przykłady / specyfikacja / test -> AI -> implementacja -> weryfikacja. Test lub przykład pełni zatem funkcję wykonywalnej specyfikacji. AI może napisać jego techniczną implementację, ale człowiek kontroluje znaczenie.
2. Harness / Verification Engineering
Simon Willison, Mitchell Hashimoto, Geoffrey Huntley oraz zespoły pracujące nad agentami w OpenAI i Google. Główne pytanie: jak sprawić, żeby agent sam dowiedział się, że zrobił źle? Agent dostaje przy tym dostęp do testów, kompilatora, type checkera, przeglądarki, logów i analizy statycznej. Im lepszy feedback loop, tym większy zakres pracy można rozsądnie przekazać agentowi. Huntley opisuje testy, static analysis i type checking jako rodzaj backpressure w autonomicznej pętli agenta, czyli opór, który zatrzymuje zmianę niespełniającą oczekiwań i wymusza kolejną iterację [9].
3. Human-understanding-first
Łatwo dojść do wizji: AI generuje kod, AI generuje testy, AI robi review, AI poprawia, AI wdraża, a człowiek widzi zielony check. Problem? Kto właściwie rozumie system?
Moim zdaniem ryzykujemy tu oddanie AI nie tylko pracy mechanicznej, ale też rozumienia problemu. Możemy bowiem wygenerować więcej kodu, testów, dokumentacji i abstrakcji, a jednocześnie rozumieć system gorzej. Dlatego human-in-the-loop nie powinien oznaczać wyłącznie “kliknij approve”. Człowiek wnosi natomiast największą wartość tam, gdzie automatyczny oracle jest słaby: przy ocenie ryzyka, wymaganiach, architekturze, UX, kompromisach, bezpieczeństwie i niejednoznaczności.
4. Cheap / ephemeral verification
Opisane wyżej podejście do testów jednorazowych. Jeśli przygotowanie eksperymentu trwa kilka minut zamiast kilku godzin, możemy znacznie częściej weryfikować jednorazowo. Nie po to, żeby zwiększyć coverage, tylko żeby odpowiedzieć na konkretne pytanie. Automatyzacja przestaje być wyłącznie trwałym zabezpieczeniem i staje się także tanim narzędziem eksploracji.
5. Beyond traditional tests
Ostatnia perspektywa zaczyna się tam, gdzie klasyczne input -> expected output przestaje wystarczać, czyli głównie w produktach wykorzystujących LLM-y i agentów. Hamel Husain i Shreya Shankar podkreślają znaczenie analizowania rzeczywistych trace’ów i failure modes przed mechanicznym budowaniem generycznych metryk [10]. Jeszcze dalej idzie Leonardo de Moura: jeśli AI będzie generować coraz więcej kodu, samo testowanie przykładów może w krytycznych systemach nie dawać wystarczających gwarancji. Większego znaczenia nabierają zatem properties, formalne specyfikacje i machine-checked proofs [11].
Te podejścia nie konkurują ze sobą: TDD odpowiada na pytanie, co ma powstać, a harness engineering na pytanie, skąd agent dowie się, że coś zrobił źle. To różne pytania, więc nie trzeba wybierać. W sensownym systemie korzystamy z kilku jednocześnie: TDD do określenia zachowania, risk-based testing do wyboru obszarów, piramidy do wyboru poziomu, harnessu do feedbacku dla agenta, testów jednorazowych do eksperymentów, evals do zachowań niedeterministycznych i ludzkiej oceny tam, gdzie automatyczny oracle nie wystarcza.
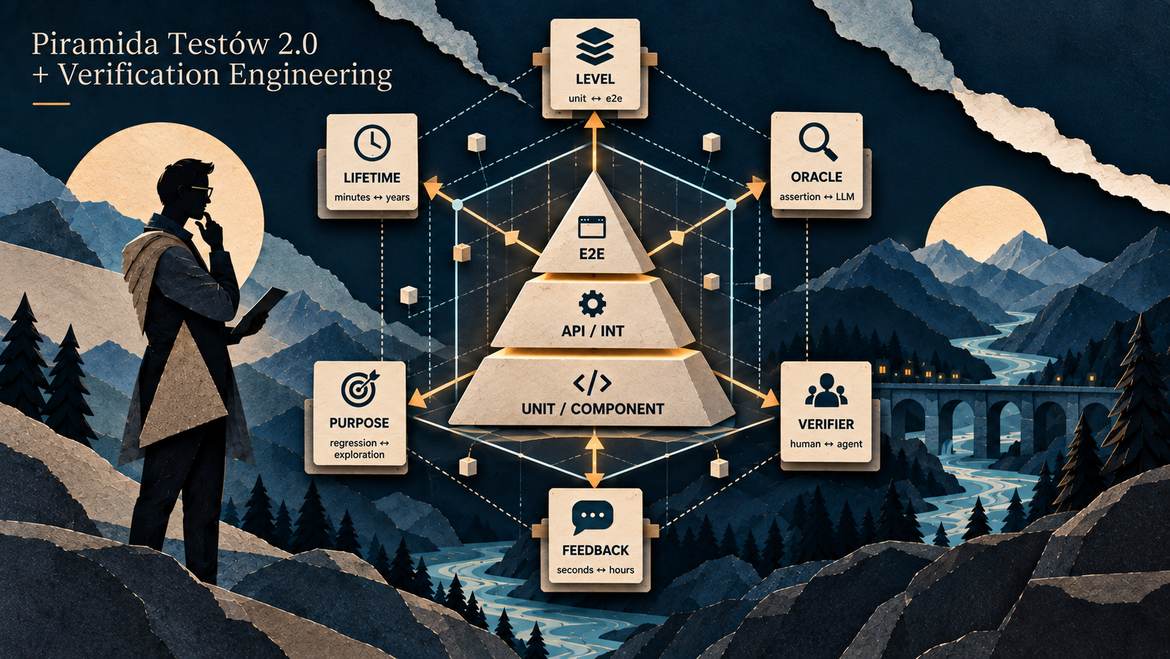
Piramida testów 2.0 a Verification Engineering: nowe wymiary
Czy w takim razie trzeba wyrzucić klasyczną piramidę testów? Nie. Piramida nadal odpowiada przecież na ważne pytanie – na jakim poziomie najlepiej sprawdzić dane zachowanie? Unit, component, integration, API, contract czy E2E? Nadal chcemy przy tym dużo szybkiego feedbacku niskiego poziomu oraz znacznie mniej wolnych, szerokich testów end-to-end [14].
AI dodaje jednak kolejne wymiary, których piramida nie opisuje:
| Pytanie | Klasyczna piramida | Verification Engineering |
| Na jakim poziomie testujemy? | unit / integration / E2E | nadal tak samo |
| Kto weryfikuje? | człowiek, test runner | także agent lub inny model |
| Jak długo test istnieje? | do końca życia produktu | od pięciu minut do lat |
| Po co powstaje? | regresja | regresja, specyfikacja, eksploracja, debugging, quality gate |
| Jaki oracle? | deterministyczna asercja | asercja, property, human review, LLM grader |
| Jak szybko jest feedback? | zależy od poziomu | projektowany świadomie: sekundy dla agenta |
| Co weryfikujemy? | produkt | produkt i zachowanie agenta |
Piramida testów 2.0 jest dla mnie nadal potrzebna, nie wyczerpuje jednak całego problemu.
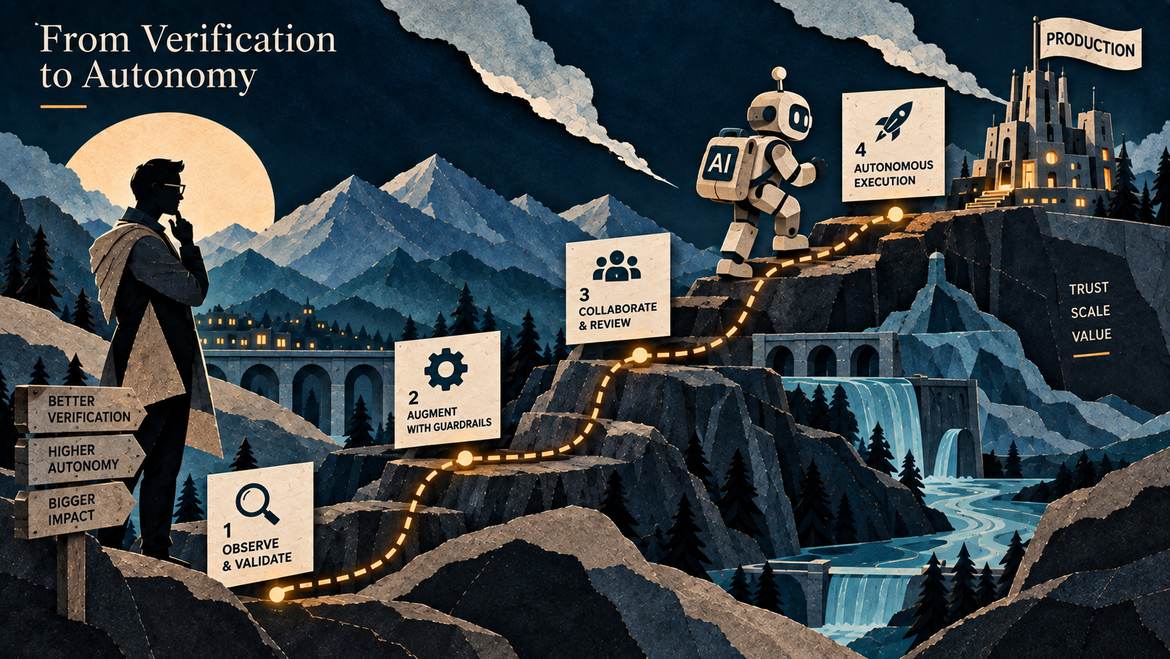
Autonomia agenta AI rośnie razem z jakością weryfikacji
Autonomia agenta nie powinna zależeć wyłącznie od tego, jak dobry jest model, ale również od tego, jak dobrze możemy zweryfikować rezultat jego pracy.
Załóżmy dwa projekty.
Projekt A ma szybkie testy, type checking, dobre testy integracyjne, kontrakty, quality gates, stabilny CI, łatwy lokalny setup, dobrą observability, dane testowe i możliwość uruchomienia aplikacji przez agenta.
Projekt B ma godzinny pipeline, niewiele testów, flaky E2E, brak lokalnego środowiska, ręczny deployment, słabe logi i dokumentację sprzed trzech lat.
Ten sam agent nie powinien zatem dostać w obu projektach takiego samego poziomu autonomii. Projekt A ma dużo mechanizmów, które szybko pokażą, że coś poszło źle. Natomiast w projekcie B agent może bardzo szybko produkować więcej niezweryfikowanego kodu. Dlatego reguła bywa prosta – w projekcie A agent otwiera PR bez pytania, a człowiek ocenia gotowy rezultat, a w projekcie B każdy większy krok wymaga zatwierdzenia, dopóki nie zbudujemy podstawowego harnessu.
To łączy Verification Engineering z modelami dojrzałości AI [15]. Wyższy poziom dojrzałości nie oznacza “mamy bardziej autonomicznego agenta”, tylko raczej: zbudowaliśmy środowisko, w którym możemy pozwolić agentowi na większą autonomię bez proporcjonalnego wzrostu ryzyka.
Szybkość feedbacku też jest cechą jakości
Nie liczy się tylko to, czy potrafimy wykryć błąd, ale również jak szybko. Agent działający przez pół godziny, który dopiero na końcu odkrywa, że pierwsza decyzja była błędna, marnuje czas, tokeny, compute i kontekst.
Dlatego feedback powinien być możliwie szybki, precyzyjny, lokalny i jednoznaczny. To także kolejny argument za mocnymi testami niskiego poziomu. Jeśli agent zmienił jedną funkcję, idealnie byłoby, żeby w kilka sekund dowiedział się “ten przypadek nie działa”, a nie po 35 minutach “któryś z 400 testów E2E nie przechodzi”.
Podobnie jak u człowieka: dobry test wykrywa problem i od razu pokazuje, gdzie on jest.
W skrócie zanim zwiększysz autonomię agenta, sprawdź, jak szybko projekt wykrywa jego błędy.
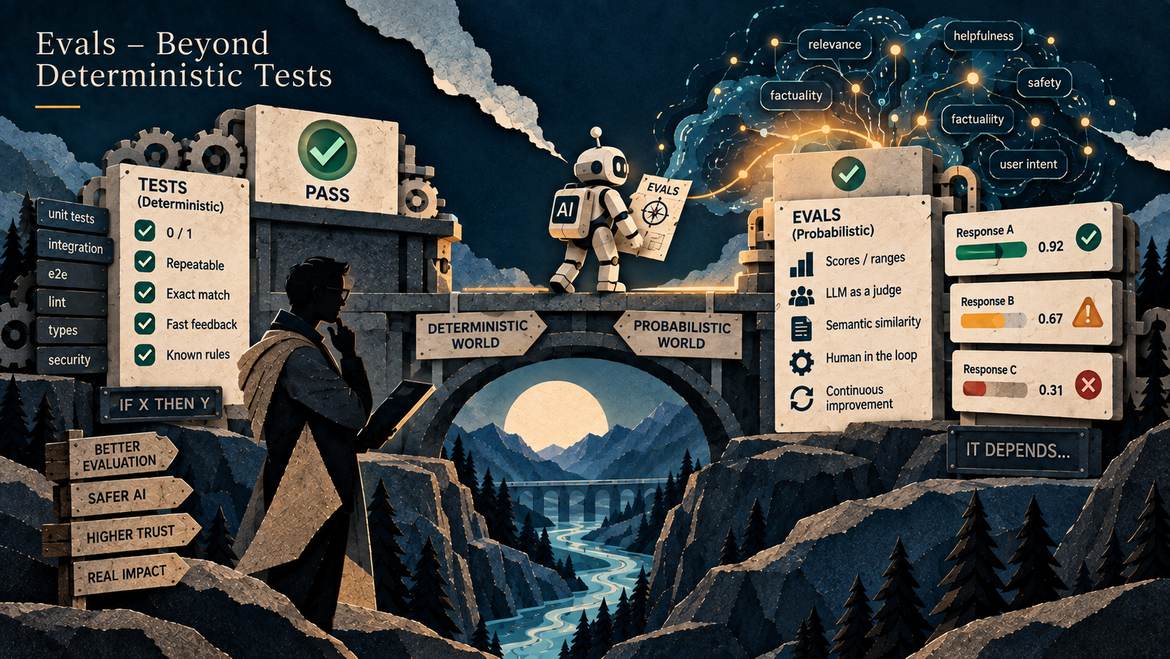
Testowanie aplikacji, które same używają AI: evals zamiast asercji
Do tej pory mówiliśmy o sytuacji, w której AI tworzy software, ale software pozostaje deterministyczny. Jeśli agent pomaga stworzyć endpoint REST, walidację formularza, logikę koszyka, system uprawnień czy kalkulator ceny, klasyczne podejścia działają bardzo dobrze i możemy definiować input -> expected output.
Sytuacja wygląda inaczej, gdy w samym produkcie mamy LLM, RAG, agenta AI, generowanie tekstu, klasyfikację probabilistyczną albo system podejmujący niedeterministyczne działania. Wtedy nie zawsze istnieje bowiem jedna poprawna odpowiedź i nie możemy oczekiwać response === exactly_this_sentence.
Potrzebujemy więc innego systemu oceny: eval datasets, graders, human review, production traces, monitoring jakości, statystyczne progi akceptacji i regresyjne evals. Nie oznacza to wyboru “testy albo evals”, bo deterministyczna część produktu nadal powinna mieć klasyczne testy. Evals dokładamy natomiast tam, gdzie poprawność ma inny charakter.
Evals dla samych agentów
Ten sam mechanizm działa w drugą stronę, do oceny samych agentów. Google w materiale o harness engineeringu proponuje na przykład testować zachowanie agentów kodujących za pomocą małych behavioral evals – czy agent użył odpowiedniego narzędzia, czy zweryfikował rezultat, czy wykonał wymagany krok przed zakończeniem zadania [7]. Większe benchmarki E2E i małe behavioral checks pełnią tam zatem różne role i uzupełniają się. W efekcie zaczyna to przypominać piramidę testów dla agentów: dużo tanich sprawdzeń pojedynczych zachowań i niewiele kosztownych benchmarków end-to-end.
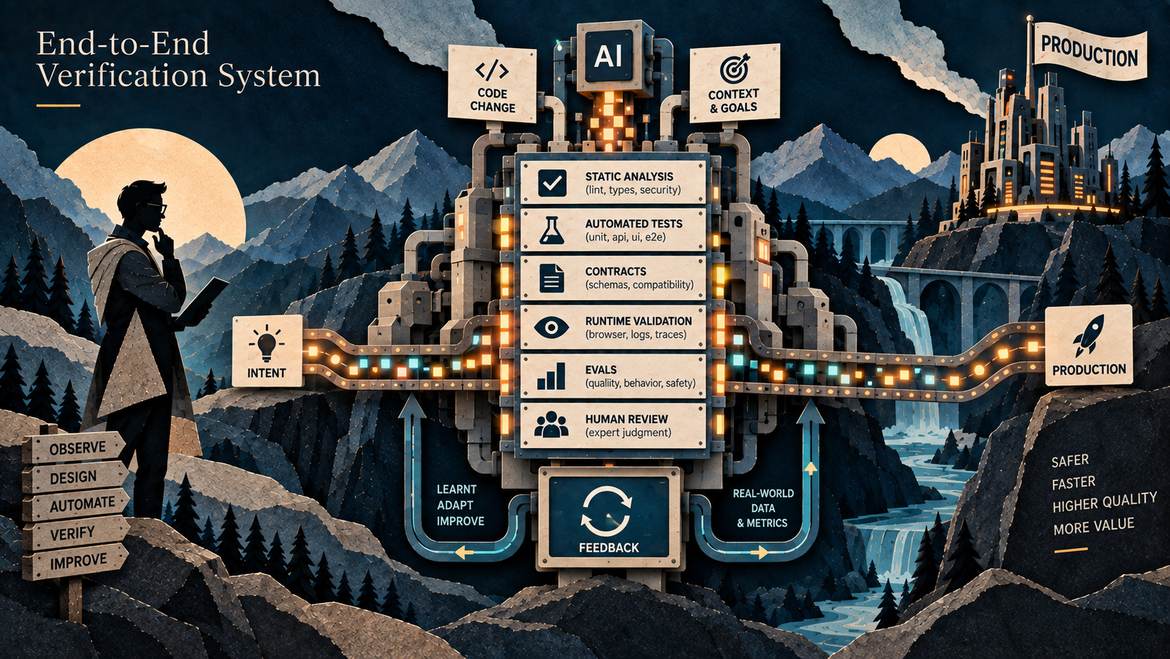
Jak wygląda cały system weryfikacji: mapa Verification Engineering
Jeśli połączymy wszystkie opisane podejścia, dostajemy mniej więcej taki model:
- Intencja człowieka: wymagania, ryzyko, UX.
- Specyfikacja: przykłady, testy, kontrakty.
- Agent i implementacja.
- Szybki feedback: unit testy, typy, kompilator, lint, testy API.
- Verification harness: analiza statyczna, security, testy architektury, kontrakty, quality gates.
- Weryfikacja w runtime: przeglądarka, API, baza danych, screenshoty, logi, traces.
- Evals: probabilistyczne zachowanie AI.
- Ocena człowieka: ryzyko, architektura, UX, biznes.
- Feedback produkcyjny, który wraca do punktu pierwszego.
To nie kolejna piramida testów, tylko mapa źródeł, z których bierzemy pewność potrzebną do zaakceptowania zmiany.
Co Verification Engineering oznacza dla QA, SDET i Test Architecta
Jeśli ten kierunek się utrzyma, część pracy związanej z automatyzacją stanie się tańsza. AI napisze bowiem POM, DTO, fixture, mock, test API, unit test, test data builder, prosty test Playwright, helper i konfigurację CI.
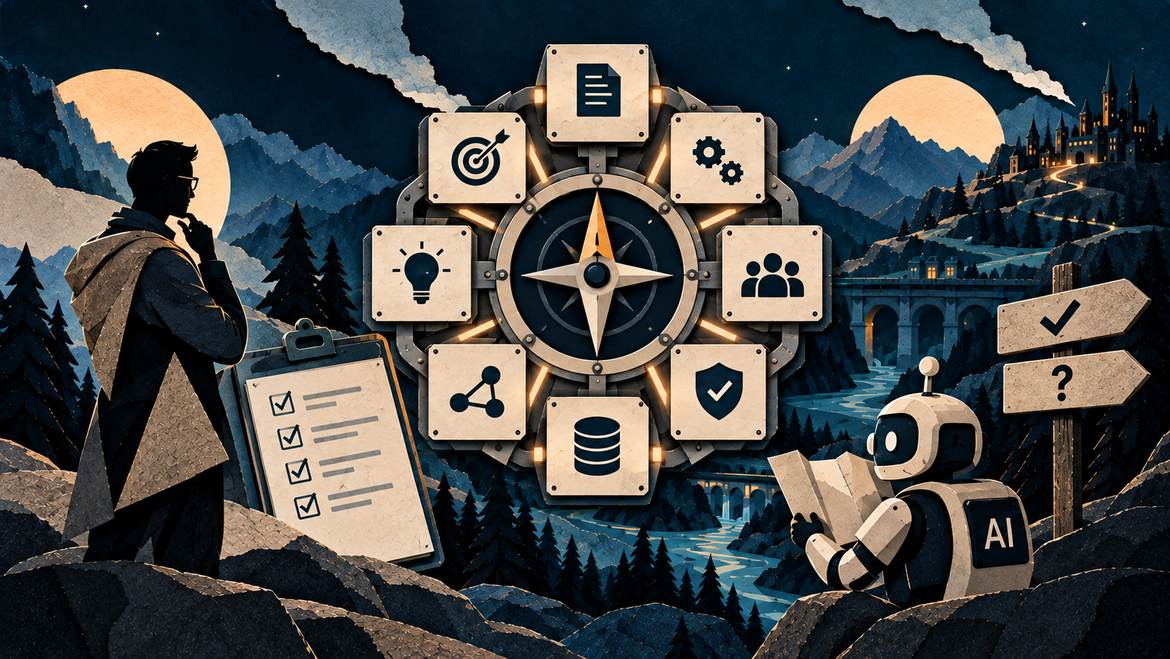
Kompetencje jakościowe są zatem nadal potrzebne, tylko w innym miejscu procesu. Zamiast pytania “jak napisać ten test?” ważniejsze stają się pytania: na jakim poziomie to sprawdzić? Czy wynik powinien blokować merge? Jakie ryzyko nadal pozostaje? Pełną listę pytań znajdziesz w checkliście w następnej sekcji. To znacznie bliżej Quality Engineering i architektury jakości niż tradycyjnego rozumienia automatyzacji.
Test Architect projektuje nie tylko test framework, ale i harness dla agenta
Przez wiele lat architekt automatyzacji projektował przede wszystkim strukturę frameworka, POM-y, fixtures, zarządzanie danymi, raportowanie, integrację z CI i standardy testów. Natomiast w świecie agentic development dochodzi kolejna warstwa: architektura feedbacku dla agentów.
Czy agent:
- wie, jak uruchomić aplikację i testy?
- potrafi uruchomić tylko potrzebny fragment suite?
- ma dostęp do logów i może użyć prawdziwej przeglądarki?
- może wygenerować dane testowe?
- rozumie failure output?
- dostaje jasną informację o regułach architektury?
- potrafi zweryfikować zmianę przed oznaczeniem zadania jako zakończone?
- ma ograniczenia bezpieczeństwa i wie, kiedy potrzebna jest decyzja człowieka?
To pytania o architekturę, a nie o prompt.
Nie sugeruję, że powinniśmy wymyślić kolejny tytuł stanowiska. Bardziej interesuje mnie natomiast zmiana perspektywy. Można ją pokazać jako kolejne warstwy pytań, które zadajemy o jakość:
| Etap | Główne pytanie |
| Testing | Czy produkt działa? |
| Test Automation | Jak automatycznie sprawdzać, czy produkt działa? |
| Quality Engineering | Jak budować jakość w całym procesie wytwarzania? |
| Verification Engineering | Jak zaprojektować system, który pozwala człowiekowi i AI szybko oraz wiarygodnie ocenić poprawność kolejnych zmian? |
Verification Engineering nie zastępuje tu Quality Engineering. To raczej jego kolejna warstwa. Praca z agentami sprawia bowiem, że samo zdobycie wiarygodnego dowodu poprawności staje się osobnym problemem inżynierskim.
Jak zacząć: checklista Verification Engineering w 8 pytaniach
Verification Engineering może brzmieć jak kolejna wielka transformacja, ale nie musi nią być. Najprostszy początek to jedno pytanie:
Gdy agent zrobi coś źle, skąd ma się o tym dowiedzieć?
Jeśli odpowiedź brzmi “z mojego code review”, znaleźliśmy pierwsze miejsce na usprawnienie. Może potrzebujemy testu jednostkowego, reguły lint, kontraktu API albo po prostu dostępu do logów – pełne kategorie znajdziesz w ramce o harnessie wyżej. A czasami odpowiedzią nadal będzie “musi ocenić to człowiek”. To też jest poprawny mechanizm weryfikacji.
Pierwszy krok bywa banalny. W pliku AGENTS.md zamiast kolejnej listy zakazów dopisujemy procedurę zakończenia zadania:
Przed oznaczeniem zadania jako zakończone:
1. uruchom `npm run typecheck && npm run lint`,
2. uruchom `npm test -- --changed`,
3. otwórz zmieniony ekran w przeglądarce i dołącz screenshot do PR,
4. jeśli któryś krok nie przechodzi, popraw i zacznij od punktu 1.
Feedback loop projektujemy pod ryzyko konkretnej zmiany, a nie pod pełne pokrycie automatyzacją. Dlatego dla każdego większego workflow z AI warto przejść przez osiem pytań.
1. Co oznacza poprawny rezultat?
Czy mamy wymaganie, przykład, kontrakt, kryteria akceptacji, property albo inne wiarygodne oracle?
2. Co agent może zweryfikować automatycznie?
Czy może użyć testów, kompilatora, type checkera, API, aplikacji, przeglądarki, logów i traces?
3. Jak szybko dostanie feedback?
Czy musi uruchamiać całe CI, czy może dostać odpowiedź lokalnie w kilka sekund?
4. Czy feedback jest niezależny od implementacji?
Czy AI generuje jednocześnie rozwiązanie i test potwierdzający własne założenia?
5. Czy test musi zostać na stałe?
Czy to regresja lub specyfikacja, czy tylko eksperyment, debugging albo jednorazowa weryfikacja?
6. Jaki jest koszt fałszywej pewności?
Co się stanie, jeśli wszystkie automatyczne mechanizmy powiedzą “green”, a rozwiązanie nadal będzie błędne?
7. Gdzie potrzebujemy człowieka?
Przy wymaganiach, architekturze, security, UX, release, zmianach wysokiego ryzyka?
8. Co będzie mechanizmem produkcyjnego feedbacku?
Czy po wdrożeniu nadal potrafimy wykryć problem, którego nie znaleźliśmy wcześniej?
Podsumowanie: Verification Engineering w praktyce
Zamiast pytać “jaką metodologię testowania stosować z AI”, lepiej pytać: jaki zestaw niezależnych sygnałów daje nam wystarczającą pewność, żeby zaakceptować tę konkretną zmianę?
Czasem będzie to unit test, czasem kontrakt API, czasem screenshot z przeglądarki, czasem eval na tysiącu przykładów, a czasem człowiek. Ważne, żeby ten zestaw wynikał z ryzyka i rodzaju systemu, a nie z przypadku.
Najważniejsze wnioski
- AI nie zmniejsza potrzeby weryfikacji. Więcej zmian w krótszym czasie oznacza więcej rzeczy do sprawdzenia.
- Tanieje napisanie testu, nie ustalenie poprawności. Asercję wygeneruje model, natomiast odpowiedź, jaka wartość jest poprawna, nadal jest po naszej stronie.
- Test staje się sygnałem sterującym agentem, nie tylko zabezpieczeniem przed regresją.
- Test suite to jedno ze źródeł sygnału. Kompilator, typy, kontrakty, analiza statyczna, przeglądarka, logi, security checks i evals też budują pewność.
- Nie każdy test musi zostać w repozytorium. Test jednorazowy, skasowany po pięciu minutach, też dostarcza informacji.
- Autonomia agenta powinna rosnąć razem z jakością weryfikacji, nie tylko z jakością modelu.
- Człowiek nadal odpowiada za najtrudniejszy oracle: znaczenie, ryzyko, architekturę i decyzję, co oznacza “wystarczająco dobrze”.
Dyskusja “czy AI będzie pisać za nas testy” wydaje mi się coraz mniej interesująca. Oczywiście, że będzie. Ciekawsze pytanie brzmi: kto zaprojektuje system, dzięki któremu AI dowie się, że zrobiło coś źle? W świecie, w którym koszt generowania kodu spada, wartość przesuwa się od tego, kto wyprodukuje najwięcej kodu, do tego, kto potrafi szybko i wiarygodnie ocenić, czy ten kod jest poprawny.
Jeśli chcesz to zastosować u siebie, przejdź checklistą przez jeden workflow, w którym agent pracuje u Ciebie najczęściej. A jeśli chcesz rozwijać te umiejętności w praktyce, sprawdź program AI_Testers (aitesters.pl) [16].
FAQ
Czym jest Verification Engineering?
Najkrócej: to projektowanie systemu, który pozwala szybko i wiarygodnie ocenić, czy zmiana jest poprawna.
W tym artykule używam określenia Verification Engineering szerzej niż samo “pisanie testów”. Obejmuje ono testy automatyczne, typy, kompilator, lint, kontrakty, analizę statyczną, security checks, sprawdzenia w runtime, evals, observability oraz ocenę człowieka.
Chodzi nie o pojedynczy test, ale o cały feedback loop:
intencja -> zmiana -> weryfikacja -> feedback -> poprawka
W świecie agentów AI jest to szczególnie ważne, ponieważ wynik weryfikacji może być od razu wykorzystany przez agenta do kolejnej iteracji.
Przykład: agent zmienia endpoint API, a type checker wykrywa błąd w kilka sekund, test kontraktowy pokazuje zmianę schematu odpowiedzi i test API potwierdza zachowanie biznesowe. Dzięki temu agent dostaje trzy niezależne sygnały i może sam poprawić implementację.
Czy Verification Engineering to nowa metodologia?
Nie, i nie traktuję go tutaj jako nowej oficjalnej metodologii testowania.
Samo verification ma zresztą długą historię w inżynierii systemów. ECSS definiuje verification jako proces dostarczania obiektywnych dowodów, że produkt został zaprojektowany i wykonany zgodnie ze specyfikacją [17]. Podobne podejście od lat funkcjonuje również między innymi w inżynierii hardware.
Traktuję je tutaj przede wszystkim jako szerszą ramę dla agentic software development: projektowanie mechanizmów, które pozwalają człowiekowi i AI zdobywać wiarygodne informacje o poprawności kolejnych zmian.
Nie twierdzę więc, że powstała nowa oficjalna metodyka o ustalonej definicji. Bardziej interesuje mnie zmiana perspektywy: kiedy kod coraz częściej tworzy agent, samo generowanie staje się łatwiejsze, a coraz większym problemem staje się wiarygodna weryfikacja rezultatu.
Czym Verification Engineering różni się od Test Automation i Quality Engineering?
Test Automation skupia się na automatyzowaniu sprawdzeń, Quality Engineering patrzy szerzej na jakość procesu i produktu, a Verification Engineering na tym, skąd bierzemy wiarygodny sygnał, że konkretna zmiana jest poprawna.
Można to uprościć:
- Test Automation: jak automatycznie sprawdzać zachowanie systemu?
- Quality Engineering: jak budować jakość w całym procesie wytwarzania?
- Verification Engineering: jakie mechanizmy dadzą człowiekowi i agentowi wystarczającą pewność, że tę zmianę można zaakceptować?
Nie traktuję Verification Engineering jako następcy Quality Engineering, to raczej dodatkowa perspektywa, która nabiera znaczenia wraz ze wzrostem autonomii agentów AI.
Czy AI zastąpi automatyzację testów?
Nie, AI może znacznie obniżyć koszt napisania testu, ale nie usuwa potrzeby weryfikacji.
Wręcz przeciwnie – jeżeli agent potrafi w kilka minut zmienić kilkanaście plików, wygenerować migrację, zmodyfikować API i poprawić frontend, powstaje więcej zmian, które trzeba szybko sprawdzić.
Zmienia się natomiast rola automatyzacji. Test nie musi być już tylko zabezpieczeniem uruchamianym później w CI, może być bezpośrednim sygnałem sterującym pracą agenta.
Przykład: agent zmienia funkcję naliczającą rabat, a unit test natychmiast pokazuje failing case. Następnie agent czyta failure, poprawia implementację i ponownie uruchamia test. Dzięki temu człowiek nie musi uczestniczyć w każdej iteracji.
Czy AI zastąpi testerów automatyzujących?
Nie, ale przesuwa ciężar pracy z pisania testów na projektowanie weryfikacji.
AI napisze na przykład POM, fixture, mock, test API, prosty test Playwright czy konfigurację CI. Tańsza staje się zatem implementacja testu, nie decyzja o tym, co i na jakim poziomie sprawdzamy.
Zamiast pytania “jak napisać ten test?” częściej odpowiadamy na pytania: skąd bierzemy wiarygodny oracle, czy wynik powinien blokować merge i jakie ryzyko zostaje po zielonym pipelinie.
Przykład: agent generuje dwadzieścia testów modułu rabatów w kilka minut, a po naszej stronie zostaje pytanie, czy status VIP łączy się z promocją i które z tych testów w ogóle warto trzymać w repozytorium.
Czym różni się harness engineering od Verification Engineering?
Harness engineering dotyczy przede wszystkim środowiska, w którym agent może pracować, sprawdzać rezultat i reagować na feedback, natomiast Verification Engineering jest szerszym pytaniem o to, jak zdobywamy wystarczające dowody poprawności.
Harness może zawierać:
- test runner,
- type checker,
- linter,
- kompilator,
- dostęp do aplikacji,
- przeglądarkę,
- logi,
- test data,
- skrypty walidacyjne,
- quality gates.
OpenAI opisuje zresztą podobną zmianę jako przejście od ręcznego tworzenia kodu w stronę projektowania środowiska, narzędzi i feedback loops, w których agent może pracować bardziej niezawodnie [3].
Przykład: zakaz page.waitForTimeout() zapisany w AGENTS.md jest instrukcją, natomiast reguła ESLint, która natychmiast blokuje takie wywołanie, jest częścią harnessu. Natomiast decyzja, że ten check razem z testami, kontraktami i browser verification daje wystarczającą pewność przed mergem, jest już problemem Verification Engineering.
Czy agent AI może sam pisać testy do własnego kodu?
Może, ale nie powinniśmy automatycznie traktować takich testów jako niezależnego dowodu poprawności.
Największym ryzykiem jest bowiem powielenie tego samego błędnego założenia w implementacji i w teście.
Jeśli agent uznał błędnie, że klient VIP powinien dostać 10% rabatu, może napisać:
implementacja -> 10%
test -> oczekiwane 10%
wynik -> green
Problem polega jednak na tym, że prawidłowa wartość mogła wynosić 15%.
Dlatego szczególnie wartościowe są niezależne źródła oczekiwanego zachowania: wymagania, przykłady biznesowe, kontrakty, properties, zaakceptowane scenariusze albo decyzja eksperta domenowego.
AI może napisać techniczną implementację testu, nie oznacza to jednak, że AI powinno samodzielnie zdecydować, co jest prawidłowym wynikiem.
Czy zielone testy oznaczają, że zmiana działa?
Nie, zielony test suite mówi przede wszystkim, że nie znaleźliśmy problemów i błędów za pomocą testów, które już posiadamy.
Nie gwarantuje natomiast, że:
- aplikacja w ogóle poprawnie się uruchamia,
- przetestowaliśmy właściwe zachowanie,
- UI wygląda poprawnie,
- nie brakuje ważnego scenariusza,
- nasze oczekiwania były poprawne.
Dlatego Simon Willison proponuje agentic manual testing: agent po implementacji rzeczywiście używa rozwiązania – uruchamia aplikację, wykonuje request, otwiera stronę, korzysta z przeglądarki, analizuje screenshoty lub logi [4].
Przykład: 124 testy przechodzą, agent otwiera jednak checkout w przeglądarce i odkrywa, że na małym ekranie przycisk “Zapłać” znajduje się pod stopką. Test suite był zielony, ale produkt nadal miał błąd.
Czym jest test oracle i dlaczego staje się tak ważny przy AI?
Test oracle to źródło informacji pozwalające stwierdzić, czy otrzymany rezultat jest poprawny.
Najprostszy oracle wygląda tak:
actual === expected
Ale najtrudniejsze pytanie brzmi: skąd wzięło się expected?
Oracle może pochodzić między innymi z:
- reguły biznesowej,
- specyfikacji,
- kontraktu,
- systemu referencyjnego,
- matematycznej właściwości,
- zaakceptowanego przykładu,
- wiedzy eksperta.
AI bardzo szybko wygeneruje:
expect(discount).toBe(15);
Nie oznacza to jednak, że wie, czy poprawna odpowiedź to 15, 10 czy 0.
Dlatego wraz ze spadkiem kosztu generowania kodu najtrudniejszą częścią pracy zostaje ustalenie, co właściwie oznacza poprawność.
Czy każdy test wygenerowany przez AI powinien zostać w repozytorium?
Nie, test może być wartościowy, nawet jeśli istnieje tylko przez kilka minut.
Warto rozróżnić dwie kategorie:
Persistent verification chroni system długoterminowo: to między innymi test regresji, kontrakt albo quality gate.
Ephemeral verification odpowiada na konkretne pytanie tu i teraz, a po uzyskaniu odpowiedzi kod może zostać zresztą usunięty.
Przykład: agent generuje prosty skrypt, który wykonuje 200 requestów przeciwko starej i nowej wersji endpointu, następnie porównuje czasy, zapisuje wynik w PR i usuwa skrypt.
Nie potrzebujemy kolejnego testu utrzymywanego przez pięć lat, bo potrzebowaliśmy odpowiedzi tylko na jedno pytanie.
Czy code coverage nadal ma sens, skoro AI generuje testy?
Ma, ale jako wskaźnik, a nie cel. Przy tanim generowaniu testów łatwo podnieść pokrycie, nie wiedząc o systemie nic więcej niż wcześniej.
500 zielonych testów nie daje większej pewności niż 100, jeżeli wszystkie opierają się na tym samym założeniu. Test suite oceniamy po tym, ile wnosi informacji.
Koszt napisania testu maleje, ale zostaje koszt jego posiadania: czas wykonywania, utrzymanie, interpretacja awarii i szum w pipelinie. Kent C. Dodds opisuje, że jego agenci generowali dużo testów o niskim sygnale, więc zaczął je automatycznie analizować i usuwać [8].
Przykład: agent dopisuje kilkadziesiąt testów wrapperów i oczywistych wartości. W efekcie coverage rośnie o kilka punktów, a żaden z tych testów nie wykryje błędu w regule biznesowej, o którą naprawdę nam chodzi.
Czy TDD nadal ma sens przy pracy z agentami AI?
Tak, szczególnie jako sposób niezależnego zdefiniowania oczekiwanego zachowania. Nie oznacza to jednak, że agent zawsze musi mechanicznie wykonywać pełny rytuał Red -> Green -> Refactor.
Największą wartością podejścia test-first przy AI jest bowiem rozdzielenie dwóch rzeczy:
co powinno się wydarzyć od jak zostanie to zaimplementowane.
Możemy więc najpierw ustalić przykłady, kryteria lub testy, a dopiero później poprosić agenta o implementację.
Birgitta Böckeler w niewielkim eksperymencie nie znalazła zresztą jednoznacznej przewagi zmuszania agentów do pełnego cyklu TDD nad pracą bez takiej instrukcji [6]. Sama podkreśla ograniczenia eksperymentu, ale prowadzi on do ciekawego wniosku: ważniejsze od odtwarzania procesu pracy człowieka może być zapewnienie agentowi dobrego, niezależnego feedbacku.
Przykład: człowiek definiuje pięć zaakceptowanych przykładów naliczania rabatu, a agent może później napisać zarówno testy, jak i implementację. Kluczowe jest przy tym to, że oczekiwane wyniki powstały wcześniej i niezależnie od kodu.
Czym testy różnią się od evals?
Klasyczny test najczęściej sprawdza deterministyczne oczekiwanie, natomiast eval ocenia jakość zachowania, dla którego nie zawsze istnieje jedna poprawna odpowiedź.
Dla klasycznego API możemy sprawdzić:
POST /order
-> status 201
-> total = 149.99
Tutaj mamy oczywiście konkretny expected result.
Natomiast dla chatbota albo agenta odpowiedź może być za każdym razem trochę inna. Zamiast jednej wartości możemy więc zdefiniować kryteria:
co najmniej 95% odpowiedzi zawiera poprawną kwotę,
0% ujawnia dane innego użytkownika,
odpowiedź mieści się w określonych zasadach.
W takim razie potrzebujemy datasetu, graderów, progów akceptacji i analizy failure modes. Hamel Husain i Shreya Shankar zwracają przy tym uwagę, żeby nie zaczynać od przypadkowych generycznych metryk, ale najpierw przyjrzeć się rzeczywistym danym i problemom produktu [10].
Testy i evals nie konkurują ze sobą: deterministyczne części systemu nadal testujemy klasycznie, natomiast evals dodajemy tam, gdzie sama natura poprawności jest probabilistyczna lub jakościowa.
Czym jest agentic manual testing?
To sprawdzenie zmiany przez agenta, który naprawdę używa aplikacji, zamiast poprzestać na uruchomieniu test suite.
Agent uruchamia zatem aplikację, wykonuje request przez curl, otwiera stronę w przeglądarce, przechodzi flow użytkownika, ogląda screenshot i zagląda do logów. Jeśli znajdzie problem, odtwarza go jako failing test, poprawia implementację i doprowadza test do zielonego.
Simon Willison opisuje to jako uzupełnienie testów automatycznych, a nie ich zamiennik [4]. Test suite pilnuje tego, co już sprawdzamy, natomiast agentic manual testing ma znaleźć to, czego jeszcze nie sprawdzamy.
Przykład: agent przechodzi flow “dodaj do koszyka -> checkout”, robi screenshot i widzi, że na małym ekranie przycisk “Zapłać” zasłania stopka, czego żaden z istniejących unit testów nie mógł przecież złapać.
Czy agentic manual testing oznacza więcej testów E2E?
Nie, jednorazowe sprawdzenie aplikacji przez agenta nie musi stać się stałym testem wykonywanym w każdym CI.
Agent może użyć przeglądarki, API albo CLI tylko po to, żeby odpowiedzieć na pytanie:
Czy moja zmiana rzeczywiście działa po uruchomieniu?
Jeśli podczas takiego sprawdzenia znajdzie ważną regresję, wtedy możemy zdecydować, czy warto zamienić ją w trwały test.
Przykład: agent raz przechodzi flow checkoutu po zmianie frontendu i skoro wszystko działa, nie dodajemy nowego E2E. Jeśli jednak odkryje błąd w naliczaniu kosztu dostawy, reprodukujemy go na możliwie niskim poziomie i dopiero taki test zostawiamy jako regresję.
Jak dużo autonomii powinniśmy dać agentowi AI?
Nie według tego, jak dobry jest model, ale według tego, jak dobrze potrafimy zweryfikować rezultat jego pracy.
Jeśli projekt ma:
- szybkie testy,
- type checking,
- kontrakty,
- stabilne CI,
- quality gates,
- observability,
- lokalne środowisko,
- dobre dane testowe,
- możliwość sprawdzenia aplikacji przez agenta,
możemy bezpieczniej pozwolić agentowi wykonać większy fragment pracy samodzielnie.
Jeśli projekt ma głównie flaky E2E, godzinny pipeline i brak dobrych logów, autonomia tego samego modelu powinna być znacznie mniejsza.
Można to zapisać bardzo prosto:
autonomia agenta ≤ jakość naszego systemu weryfikacji
Dlatego im słabszy feedback loop, tym więcej punktów kontrolnych powinno pozostać po stronie człowieka.
Od czego zacząć Verification Engineering w istniejącym projekcie?
Nie od budowania nowej platformy. Od jednego pytania: gdy agent zrobi coś źle, skąd ma się o tym dowiedzieć?
Sprawdź zatem najczęstsze błędy pojawiające się podczas pracy z AI i zastanów się, które z nich można zamienić w automatyczny feedback.
Jeśli agent:
- łamie typy -> uruchamiaj type checker,
- używa zabronionego API -> dodaj regułę lint,
- narusza architekturę -> dodaj architecture test,
- psuje kontrakt -> dodaj contract test,
- nie zauważa problemu wizualnego -> daj mu dostęp do przeglądarki,
- kończy pracę bez uruchomienia testów -> zdefiniuj procedurę weryfikacji przed zakończeniem zadania.
Chodzi o to, żeby powtarzalne błędy zamieniać w powtarzalny feedback, a nie o automatyzowanie wszystkiego.
To często jest lepsza inwestycja niż kolejna strona instrukcji w AGENTS.md.
Źródła
- [1] Simon Willison – AI-assisted development needs automated tests
https://simonwillison.net/2025/May/28/automated-tests/ - [2] Mitchell Hashimoto – My AI Adoption Journey: Engineer the Harness
https://mitchellh.com/writing/my-ai-adoption-journey - [3] OpenAI – Harness engineering: leveraging Codex in an agent-first world
https://openai.com/index/harness-engineering/ - [4] Simon Willison – Agentic manual testing
https://simonwillison.net/guides/agentic-engineering-patterns/agentic-manual-testing/ - [5] The Pragmatic Engineer – TDD, AI agents and coding with Kent Beck
https://www.youtube.com/watch?v=aSXaxOdVtAQ - [6] Birgitta Böckeler – TDD inside the agent loop: theater or actual value?
https://martinfowler.com/articles/exploring-gen-ai/tdd-in-the-agent-loop.html - [7] Google Developers – The Anatomy of Harness Engineering
https://developers.googleblog.com/the-anatomy-of-harness-engineering-how-to-evaluate-iterate-and-guard-ai-coding-agents/ - [8] Kent C. Dodds – Better with Kent, odcinek: I Delete Tests Every Night (On Purpose)
https://kentcdodds.com/better - [9] Geoffrey Huntley – Ralph Wiggum as a software engineer
https://ghuntley.com/ralph/ - [10] Hamel Husain & Shreya Shankar – Evals Skills for Coding Agents
https://hamel.dev/blog/posts/evals-skills/ - [11] Leonardo de Moura – When AI Writes the World’s Software, Who Verifies It?
https://leodemoura.github.io/blog/2026-2-28-when-ai-writes-the-worlds-software-who-verifies-it/ - [12] David Heinemeier Hansson – System tests have failed
https://world.hey.com/dhh/system-tests-have-failed-d90af718 - [13] Theo Browne – I’m about to make a lot of people angry… (o weryfikacji i testach tymczasowych)
https://www.youtube.com/watch?v=PWAkNx5UueM - [14] jaktestowac.pl – Piramida testów 2.0: co AI zmienia w testowaniu?
https://jaktestowac.pl/piramida-testow-2-0-co-ai-zmienia-w-testowaniu/ - [15] jaktestowac.pl – Modele dojrzałości AI: postęp czy chaos?
https://jaktestowac.pl/modele-dojrzalosci-ai/ - [16] AI_Testers – program dla testerów i QA, którzy chcą skutecznie pracować z AI
https://aitesters.pl - [17] ECSS – Verification
https://ecss.nl/standard/ecss-e-st-10-02c-rev-1-verification-1-february-2018/
|
|
||
|
|||

Świetny tekst. Sam zastanawiałem się ostatnio, jak AI wpłynie na moją pracę. Definicja Verification Engineering bardzo mi rozjaśniła ten temat. Dzięki.
Dzięki i ciesze sie ze artykuł dostarczył Ci nowej perspektywy 😉