
Piramida testów 2.0: co AI zmienia w testowaniu
Jak AI zmienia samo wytwarzanie i testowanie aplikacji?
Piramida testów 2.0 to praktyczne podejście do budowania strategii testów w erze AI. Przez wiele lat klasyczna piramida testów była jednym z najbardziej praktycznych modeli porządkujących myślenie o automatyzacji testów i pozostaje fundamentem współczesnego testowania.
Czemu testy niskiego poziomu są tak ważne?
Jej podstawowy sens jest prosty:
większość testów powinna znajdować się na niskim poziomie
Powód?
Testy jednostkowe i komponentowe są zazwyczaj szybsze, tańsze i stabilniejsze niż testy end-to-end uruchamiane przez UI. Martin Fowler opisał tę ideę bardzo jasno: istotą piramidy jest przewaga testów niskopoziomu nad szerokimi testami przechodzacymi przez interfejs użytkownika. Ponadto, Google od lat wspiera podobny sposób myślenia, opisując testy jako small, medium i large – o różnym koszcie, zakresie i czasie wykonania. [1][4]
To podejście nadal jest wartościowe. Jednak kluczowe są nie tylko systemy, które budujemy, ale także sposób, w jaki je budujemy.
AI zmienia sposób, w jaki wytwarzamy oprogramowanie
Dziś AI coraz częściej bierze udział w codziennym development workflow:
- pomaga pisać kod,
- proponuje testy,
- generuje boilerplate,
- podpowiada edge case’y,
- wspiera review,
- sugeruje poprawki błędów,
- a czasem działa wręcz jak agent wykonujący większy fragment pracy.
I właśnie tutaj zaczyna się prawdziwa zmiana.
Kod generowany przez AI może zawierać subtelne błędy
Problem nie polega na tym, że piramida testów przestała działać. Natomiast kluczowa zmiana dotyczy tempa i charakteru zmian w kodzie – AI zmienia sposób wytwarzania oprogramowania. Kod powstaje szybciej, zmian jest więcej i łatwiej wygenerować nowe funkcje, endpointy i testy. Jednak to, że kod jest generowany przez AI, nie oznacza, że jest wolny od błędów. Wręcz przeciwnie – może zawierać subtelne problemy, które łatwo przeoczyć, takie jak: [6][7]
- błędne założenie,
- pozornie poprawny kod, ale niezgodny z wymaganiami,
- kod niepasujący do architektury (np. złe warstwy, złe granice),
- lub zmianę, która przejdzie lokalnie, a popsuje system dalej w pipeline.
Przegląd kodu wygenerowanego przez AI staje się istotą część workflow, dlatego pierwszym krokiem powinno być uruchomienie automatycznych testów i narzędzi statycznej analizy. Przede wszystkim, AI wzmacnia istniejące praktyki – potrafi zwiększac produktywność i wspierać jakość, ale bez dobrych praktyk może też zwiększac niestabilność i liczbę błędów.
Teza tego tekstu jest prosta: piramida testów 2.0 nie jest zmianą paradygmatu, ale praktycznym dostosowaniem klasycznej strategii testów do świata AI-assisted development.
Natomiast AI sprawia tylko, że jeszcze wyraŻniej widać, gdzie potrzebujesz szybkich testów, pewnej integracji, ograniczonych E2E i sensownej kontroli jakości zmian. Dodatkowo, dopiero tam, gdzie w produkcie pojawia się niedeterministyczny komponent AI, trzeba dołożyć evals i guardrails. [9][13][19]
- zasady dotyczące tego, jakie dane można przekazywać do modeli,
- procesy review dla zmian wygenerowanych przez AI,
- automatyczne testy bezpieczeństwa,
- monitoring działania systemu po wdrożeniu,
- i inne mechanizmy zapobiegające niepożądanym skutkom.
Piramida testów 2.0 jako praktyczne dostosowanie do AI-assisted development
Dlatego warto mówić dziś o Piramidzie testów 2.0. [6]
Nie jako o nowym modnym obrazku.
Ale jako o praktycznym dostosowaniu klasycznej strategii testów do świata AI-assisted development. [6][7]
W tej wersji piramida nadal opiera się na tych samych fundamentach:
- dużo szybkich testów niskiego poziomu,
- sensowne testy integracyjne,
- ograniczona liczba strategicznych E2E,
ale dodatkowo musi uwzględniać to, że AI:
- przyspiesza produkcję zmian,
- zwiększa potrzebę weryfikacji wygenerowanego kodu,
- zmienia sposób tworzenia i utrzymania testów,
- oraz w niektórych przypadkach wymaga dodatkowych mechanizmów oceny, takich jak evals czy guardrails.
Generatywne AI wymaga testowania wykraczającego poza tradycyjny model pass/fail, bo odpowiedzi są zmienne, ryzyka wielowymiarowe, a jakość trzeba oceniać zarówno przed wdrożeniem, jak i po nim. W prostych słowach przy systemach AI sam wynik zielony/czerwony na CI już nie wystarcza. [9][13][14]
Dlaczego mówimy dzisiaj o Piramidzie testów 2.0?
Czym właściwie była klasyczna piramida testów?
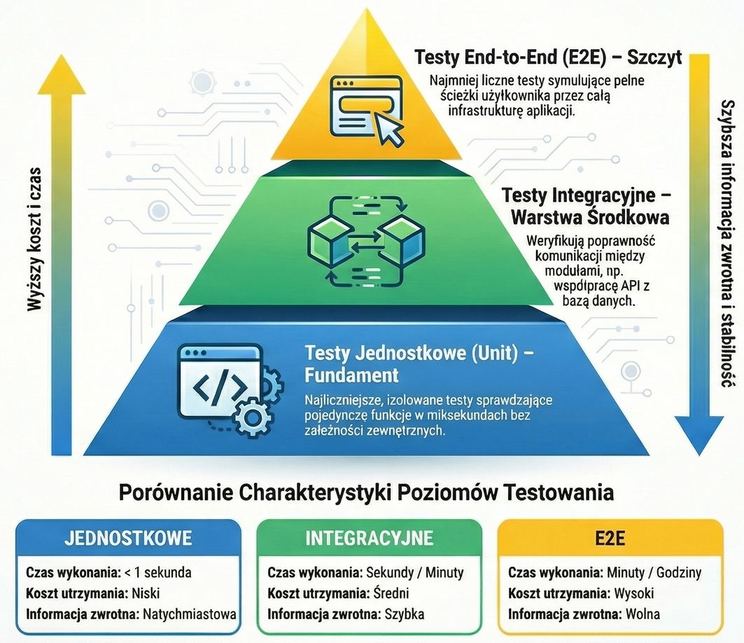
Klasyczna piramida nie była nigdy tylko rysunkiem. Niemniej jednak, była skrótem myślowym mówiącym:
nie buduj jakości głównie przez drogie testy end-to-end
Fowler pisze, że podstawowy sens piramidy polega na tym, aby większość wysiłku ulokować na niższych warstwach, a nie na skomplikowanych testach przechodzących przez GUI. Dodaje też bardzo ważną uwagę – piramida zakłada, że broad-stack (czyli testy obejmujące wiele warstw) są zazwyczaj drogie, wolne i kruche w porównaniu z testami bardziej skupionymi. [1][2]
Praktycznie oznaczało to zwykle taki układ:
- dużo testów jednostkowych,
- mniej testów integracyjnych,
- mało testów end-to-end.
To była odpowiedź na realny koszt utrzymania testów. Mianowicie, im wyżej wchodzimy, tym więcej zależności bierze udział w wykonaniu testu, tym więcej elementów może zawieść i tym trudniej jednoznacznie określić przyczynę błędu. Google opisywało to innym językiem, bo przez rozmiary testów. Jednak dochodzło do zbliżonego wniosku – małe, izolowane testy są czymś innym niż duże, szerokie testy systemowe, i oba typy pełnią inną rolę. [4]
Jednocześnie warto zaznaczyć coś, o czym dziś często się zapomina: piramida nigdy nie była matematycznym wzorem. Nawet Fowler, odnosząc się do nowszych dyskusji o “trophies”, “honeycombs” i innych kształtach, zauważa, że spór często bardziej dotyczy definicji słów “unit” i “integration” niż samej istoty problemu. Ważny wniosek brzmi, że zamiast kłócić się o procenty, lepiej skupić się na testach, które mają wyraźne granice, działają szybko, niezawodnie i dają jasną informację zwrotną. [3]
Z tego wynika pierwszy fundament wersji 2.0:
Nie chodzi o obronę jednego kształtu.
Chodzi o sensowne portfolio testów dopasowane do ryzyka, architektury i kosztu utrzymania.
Klasyczny model testów pozostaje aktualny
Chociaż AI wprowadza nowe wyzwania, fundamentalne zasady piramidy testów nadal pozostają ważne. Wynika to z bardzo prostego powodu: w większości systemów zdecydowana większość zachowań nadal pozostaje deterministyczna. Nawet jeśli zespół używa Copilota, Claude’a albo innych narzędzi do generowania kodu, sam produkt nadal zwykle składa się z logiki biznesowej, walidacji, integracji, autoryzacji, mapowania danych i reguł domenowych, które powinny być sprawdzane klasycznymi metodami. [1][4][7]
To właśnie tutaj klasyczna piramida nadal daje największą wartość.
Testy niskiego poziomu są szybkie, relatywnie tanie i dają bardzo precyzyjny feedback. Testy integracyjne pozwalają sprawdzić granice między komponentami, a ograniczona liczba testów end-to-end potwierdza najważniejsze ścieżki biznesowe z perspektywy użytkownika. Martin Fowler od lat podkreśla, że sens piramidy nie polega na obronie jednego świętego schematu, ale na unikaniu nadmiernego polegania na drogich i niestabilnych testach broad-stack (czyli testach obejmujących wiele warstw systemu). [1][3]
AI nie obala tej logiki. Wręcz przeciwnie – sprawia, że staje się jeszcze bardziej praktyczna. Skoro zmian w kodzie jest więcej, to jeszcze bardziej opłaca się inwestować w testy, które uruchamiają się szybko, jasno wskazują problem i nie zamieniają pipeline’u w korek. W opracowaniu DORA 2025 znajdziemy wnioski, że AI jest przede wszystkim wzmacniaczem istniejących praktyk organizacyjnych i inżynierskich, a nie magicznym zamiennikiem dobrego procesu. [7]
Właśnie dlatego piramida testów pozostaje aktualna również w erze AI-assisted development. Zmienia się tempo pracy, zmienia się sposób powstawania kodu, ale nie zmienia się fakt, że jakość nadal najlepiej buduje się przez sensowne portfolio testów dopasowane do ryzyka, kosztu i architektury systemu. [1][3][7]
- niektórzy dodają warstwę testów kontraktowych
- inni rozbijają testy integracyjne na testy API i testy integracyjne komponentów
- testy end-to-end są dzielone na testy UI i testy API
To wszystko są szczegóły, które nie zmieniają podstawowej logiki – większość testów powinna być szybka, tania i dawać jasny feedback.
Jeśli posiadasz Program, to lekcje znajdziesz tutaj: Piramida testów w testach automatycznych oraz Piramida testów w testach automatycznych: przykład we frameworku.
Dlaczego klasyczna piramida testów nadal jest potrzebna w erze piramidy testów 2.0?
Wiele dyskusji o AI brzmi tak, jakby wszystko trzeba było wymyślić od nowa.
To błąd.
W ogromnej liczbie systemów najbardziej kosztowne problemy nadal powstają w klasycznej logice aplikacyjnej:
- błędnych walidacjach,
- złych przeliczeniach,
- nieprawidłowym mapowaniu danych,
- regresjach w API,
- złej obsłudze autoryzacji,
- niewłaściwym cache’owaniu
- albo błędnym łączeniu komponentów.
Żaden LLM nie “naprawi” słabej architektury testów na tych poziomach.
Dlatego fundament pozostaje ten sam: [1][4]
- logikę domenową najlepiej sprawdzać nisko,
- integracje trzeba testować świadomie,
- E2E trzeba utrzymywać w ryzach,
- koszt testu powinien odpowiadać wartości, którą daje.
To nadal działa, bo nawet jeśli system zawiera warstwę AI, to większość jego zachowania nadal jest deterministyczna. Jeśli masz aplikację z chatbotem, to: [6]
- routing żądania,
- zapis historii,
- autoryzacja,
- limity,
- retry,
- przechowywanie kontekstu,
- widoki UI,
- transformacja danych
wciąż są zwykłym oprogramowaniem i powinny być testowane zwykłymi metodami.
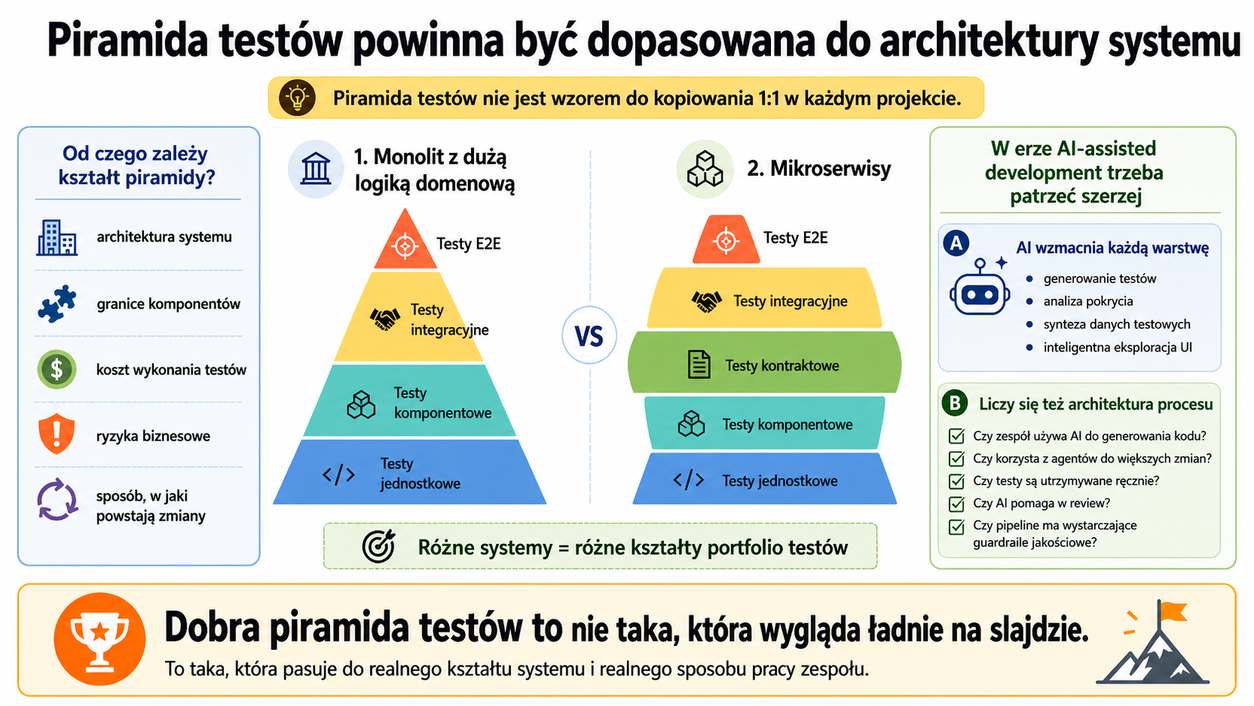
Piramida testów powinna być dopasowana do architektury systemu
Piramida testów nie jest wzorem, który należy kopiować 1:1 w każdym projekcie. [3]
Jej kształt zawsze powinien wynikać z:
- architektury systemu,
- granic komponentów,
- kosztu wykonania testów,
- ryzyk biznesowych,
- i sposobu, w jaki powstają zmiany.
Dla monolitu z dużą logiką domenową zwykle opłaca się mieć bardzo mocną bazę testów jednostkowych i komponentowych. W mikroserwisach rośnie znaczenie testów integracyjnych i kontraktowych, bo najwięcej problemów pojawia się na granicach usług. Fowler od lat pokazuje, że różne systemy potrzebują różnych kształtów portfolio testów, a nie jednego świętego diagramu. AI może wzmacniać każdą warstwę piramidy przez generowanie testów, analizę pokrycia, syntezę danych testowych czy inteligentną eksplorację UI. [6][8]
W kontekście AI-assisted development to jeszcze ważniejsze, bo dziś trzeba brać pod uwagę nie tylko architekturę systemu, ale też architekturę procesu wytwarzania. Czy:
- zespół używa AI do generowania kodu,
- korzysta z agentów do większych zmian,
- testy są utrzymywane ręcznie,
- AI pomaga w review,
- pipeline ma wystarczające guardraile jakościowe.
Dobra piramida testów to nie taka, która wygląda ładnie na slajdzie.
To taka, która pasuje do realnego kształtu systemu i realnego sposobu pracy zespołu.
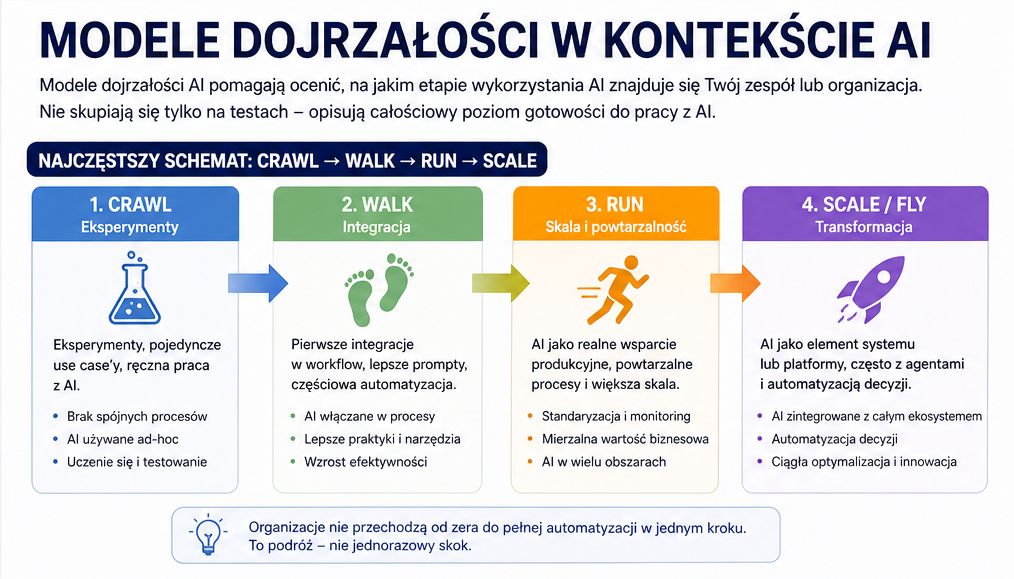
Modele dojrzałości w kontekście AI
W kontekście AI warto spojrzeć szerzej niż tylko na Piramidę testów 2.0. W ostatnich latach pojawiło się wiele modeli dojrzałości AI, które próbują odpowiedzieć na jedno kluczowe pytanie:
na jakim etapie wykorzystania AI znajduje się Twój zespół lub organizacja?
Te modele nie skupiają się wyłącznie na testach. Opisują raczej całościowy poziom gotowości do pracy z AI — od eksperymentów, przez stabilne wykorzystanie, aż po skalowanie i automatyzację na poziomie organizacji.
Najczęstszy schemat: Crawl → Walk → Run → Scale
Jednym z najczęściej spotykanych podejść jest model etapowy, często opisywany jako: [25]
- Crawl — eksperymenty, pojedyncze use case’y, ręczna praca z AI,
- Walk — pierwsze integracje w workflow, lepsze prompty, częściowa automatyzacja,
- Run — AI jako realne wsparcie produkcyjne, powtarzalne procesy i większa skala,
- Scale / Fly — AI jako element systemu lub platformy, często z elementami agentów i automatyzacji decyzji.
Ten model pojawia się w wielu wariantach — czasem jako 3 poziomy, czasem 4 lub więcej — ale jego sens pozostaje ten sam: organizacje nie przechodzą od zera do pełnej automatyzacji w jednym kroku. [26]
Modele oparte na poziomach organizacyjnych
Inne podejścia opisują dojrzałość AI bardziej formalnie — jako zestaw poziomów rozwoju organizacji:
- od awareness i eksperymentów,
- przez pilotowe wdrożenia,
- aż do pełnej integracji AI w procesach biznesowych i strategii firmy.
W takich modelach kluczowe jest to, że AI przestaje być „narzędziem dla jednostek”, a zaczyna być zdolnością organizacyjną — czymś, co wpływa na sposób podejmowania decyzji, budowania produktów i działania całego zespołu. [27][29]
Modele wielowymiarowe: więcej niż tylko technologia
Coraz częściej modele dojrzałości AI nie opisują tylko etapów, ale także różne wymiary gotowości, takie jak:
- data i jakość danych,
- infrastruktura i narzędzia,
- kompetencje zespołu,
- procesy i workflow,
- oraz governance, bezpieczeństwo i odpowiedzialność.
To ważne, bo wiele organizacji wpada w pułapkę: mają narzędzia AI, ale nie mają danych, procesu ani kontroli jakości. W praktyce oznacza to, że AI jest używane, ale nie jest jeszcze „dojrzałe”. [6]
- dokładne omówienie różnych modeli,
- ich zastosowania,
- praktyczne wskazówki, jak ocenić poziom dojrzałości AI w Twojej organizacji.
Dlaczego to ma znaczenie dla testowania?
Z perspektywy testów i jakości najważniejszy wniosek jest bardzo praktyczny:
Twoja strategia testów powinna być dopasowana do poziomu dojrzałości AI, a nie do hype’u wokół AI.
Jeżeli jesteś na etapie Crawl, największą wartość dają dobre fundamenty: szybkie testy, review, stabilny pipeline. Jeżeli jesteś na poziomie Run lub Scale, pojawiają się nowe potrzeby: evals, guardrails, monitoring jakości odpowiedzi i kontrola zachowania agentów.
Dlatego Piramida testów 2.0 najlepiej działa jako element większego obrazu. Nie zastępuje modeli dojrzałości AI, ale dobrze się z nimi uzupełnia — pokazując, jak budować jakość w zależności od tego, gdzie jesteś na tej ścieżce.
AI nie zmienia faktu, że zespoły dojrzewają etapami. Zmienia tylko tempo, w jakim widać skutki tej (nie)dojrzałości.
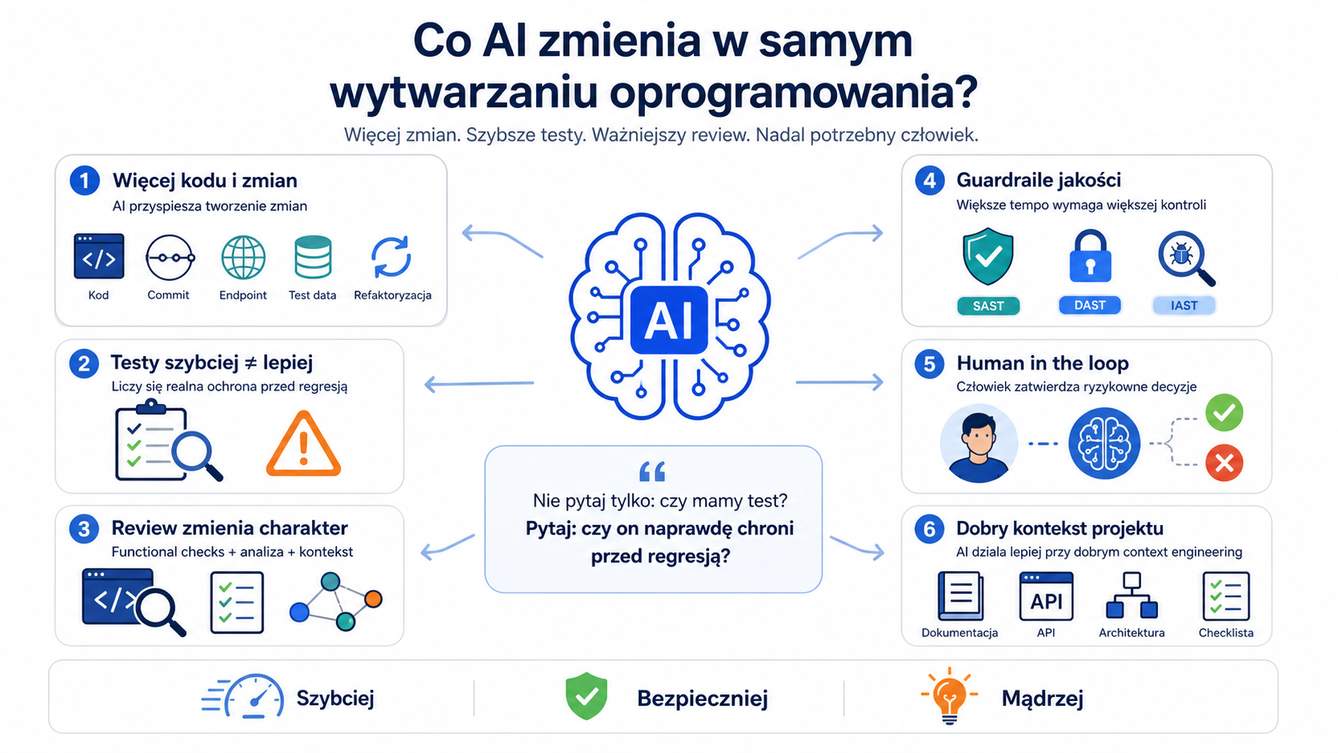
Co AI zmienia w samym wytwarzaniu oprogramowania?
AI nie tylko dodaje nowe typy systemów.
AI zmienia codzienną pracę zespołów.
Powstaje więcej kodu i więcej zmian
Jeżeli developer albo tester może w kilka minut wygenerować:
- endpoint,
- klasę serwisową,
- testy jednostkowe,
- dane testowe,
- refaktoryzację,
- szkic E2E,
W rzeczywistości liczba zmian w systemie rośnie. Chociaż to nie musi być problemem, oznacza jednak, że pipeline jakości musi działać szybciej i efektywniej, ponieważ inaczej zespół szybko straci kontrolę nad stabilność i jakość. [7][18]
Testy też mogą powstawać szybciej – ale nie zawsze są lepsze
Copilot, Claude i inne narzędzia AI wspierają pisanie, debugowanie i naprawianie testów oraz zwiększanie coverage. Przede wszystkim, są to świetne wiadomości dla zespołów, które od lat mają problem z kosztownym utrzymaniem testów. [6][16]
Jednak warto sprawdzić także druga stronę medalu:
- AI może wygenerować test, który jest powierzchownie poprawny, ale nie sprawdza istotnych aspektów funkcjonalności,
- powielając ten sam schemat,
- pomijając ważne przypadki brzegowe,
- lub tworząc test, który tylko “potwierdza” implementację zamiast realnie ją sprawdzać.
Dlatego w świecie AI-assisted development kluczowe pytanie nie brzmi już tylko:
czy mamy test?
Lepiej zapytać:
czy mamy test, który faktycznie chroni przed regresją?
Review staje się jeszcze ważniejszy
Przy kodzie generowanym przez AI review staje się jeszcze bardziej istotne i bardziej wielowymiarowe. Przegląd takiego kodu warto zaczynać od podstawowych kroków: uruchomienia testów automatycznych, kompilacji i statycznej analizy. Dopiero później należy ocenić, czy zmiana rzeczywiście rozwiązuje właściwy problem i czy pasuje do kontekstu projektu. [15]
Przy kodzie generowanym przez AI trzeba: [15]
- zacząć od functional checks, czyli podstawowych sprawdzeń funkcjonalności,
- uruchomić testy i statyczną analizę,
- sprawdzić zgodność z kontekstem i intencją zmiany,
- ocenić jakość kodu,
- przejrzeć zależności,
- szukać AI-specific pitfalls (czyli pułapek specyficznych dla kodu generowanego przez AI, takich jak nadmierna złożoność, brak obsługi edge case’ów czy niezgodność z konwencjami zespołu)
W rzeczywistości, to bardzo ważna zmiana myślenia:
AI nie zmniejsza potrzeby review. AI zmienia jego charakter.
Z czasem coraz częściej nie przeglądamy już tylko kodu napisanego przez człowieka, ale kod wygenerowany we współpracy człowieka i modelu.
Warto też pamiętać, że AI może wygenerować testy razem z kodem. Narzędzia takie jak Copilot dobrze radzą sobie ze szkicami testów jednostkowych i integracyjnych, ale bardziej złożone scenariusze wymagają lepszych promptów, a przede wszystkim późniejszej weryfikacji przez człowieka. To oznacza, że review obejmuje dziś coraz częściej nie tylko “czy kod jest poprawny?”, ale także “czy testy faktycznie chronią przed regresją?”. [16]
W praktyce w erze AI-assisted development warto rozszerzyć pipeline nie tylko o testy funkcjonalne, ale też o automatyczne mechanizmy bezpieczeństwa.
- SAST (Static Application Security Testing) pomaga wykrywać problemy w kodzie i zależnościach jeszcze przed uruchomieniem aplikacji,
- DAST (Dynamic Application Security Testing) pozwala badać działający system od zewnątrz,
- IAST (Interactive Application Security Testing) łączy obserwację działania aplikacji z analizą wykonywanego kodu.
Nie są to nowe poziomy piramidy testów, ale bardzo wartościowe uzupełnienie jakościowych guardrailów, szczególnie wtedy, gdy AI przyspiesza produkcję zmian i zwiększa ryzyko przeoczenia subtelnych błędów oraz podatności. [6]
Human in the loop nadal jest konieczny
Im więcej mówi się o agentach i automatyzacji wspieranej przez AI, tym łatwiej wpaść w fałszywe przekonanie, że człowiek może całkowicie zniknąć z procesu podejmowania decyzji. W praktyce jednak nowoczesne podejścia do budowania agentów coraz częściej zakładają dokładnie odwrotny model: człowiek powinien pojawiać się wszędzie tam, gdzie system wykonuje akcje kosztowne, ryzykowne albo trudne do odwrócenia. Human-in-the-loop (czyli człowiek w pętli decyzyjnej) może być mechanizmem wstrzymywania działania agenta do momentu, aż człowiek zaakceptuje lub odrzuci wrażliwe operacje. [21][24]
To bardzo dobrze pasuje do perspektywy zadbania o jakość. Jeżeli agent lub model proponuje zmianę w kodzie, wykonuje serię działań na systemie, wybiera narzędzia albo podejmuje decyzję na podstawie niepełnego kontekstu, sam fakt, że “doszedł do odpowiedzi”, nie powinien być jeszcze uznawany za sukces. Potrzebny jest ktoś, kto oceni sens biznesowy, zgodność z wymaganiami, bezpieczeństwo oraz ryzyko dalszych skutków. [15][21]
Human in the loop nie oznacza więc braku zaufania do AI. Oznacza raczej świadome zarządzanie zaufaniem. Człowiek nie musi ręcznie wykonywać każdej czynności, ale powinien mieć możliwość zatrzymania, zweryfikowania i zatwierdzenia tych działań, które mają większą wagę biznesową lub techniczną. To szczególnie ważne tam, gdzie agent potrafi wykonać więcej niż tylko wygenerować tekst – na przykład uruchomić narzędzie, zmodyfikować dane albo przygotować zmianę w systemie. [21][23][24]
Dlatego w Piramidzie testów 2.0 człowiek nadal pozostaje niezbędny. AI może przyspieszać pracę, ale to człowiek odpowiada za końcową ocenę jakości zmiany, za decyzję o akceptacji ryzyka i za ustawienie granic, których system nie powinien przekraczać bez dodatkowej kontroli. [7][15][21]
AI działa lepiej tam, gdzie projekt ma dobrze opisany kontekst
W praktyce AI nie wzmacnia jakości samo z siebie. Wzmacnia przede wszystkim to, co jest dobrze opisane, spójne i możliwe do powtórzenia. Jeżeli projekt ma chaotyczne standardy, niespójną architekturę, niejasne kontrakty i wiedzę ukrytą wyłącznie w głowach ludzi, to model będzie generował zmiany w oparciu o niepełny albo błędny obraz systemu.
Dlatego jednym z najbardziej niedocenianych elementów Piramidy testów 2.0 jest przygotowanie projektu pod sensowną współpracę z AI. Oznacza to między innymi:
- spisane standardy kodowania i testowania,
- jasne checklisty review,
- udokumentowane granice architektury,
- opisane kontrakty API i decyzje techniczne,
- oraz kontekst dostępny w formie, z której może korzystać zarówno człowiek, jak i agent.
Im lepiej opisany system, tym większa szansa, że AI pomoże przyspieszyć pracę bez zwiększania chaosu. Innymi słowy: Piramida testów 2.0 działa najlepiej tam, gdzie istnieje nie tylko dobra automatyzacja, ale też dobre context engineering.
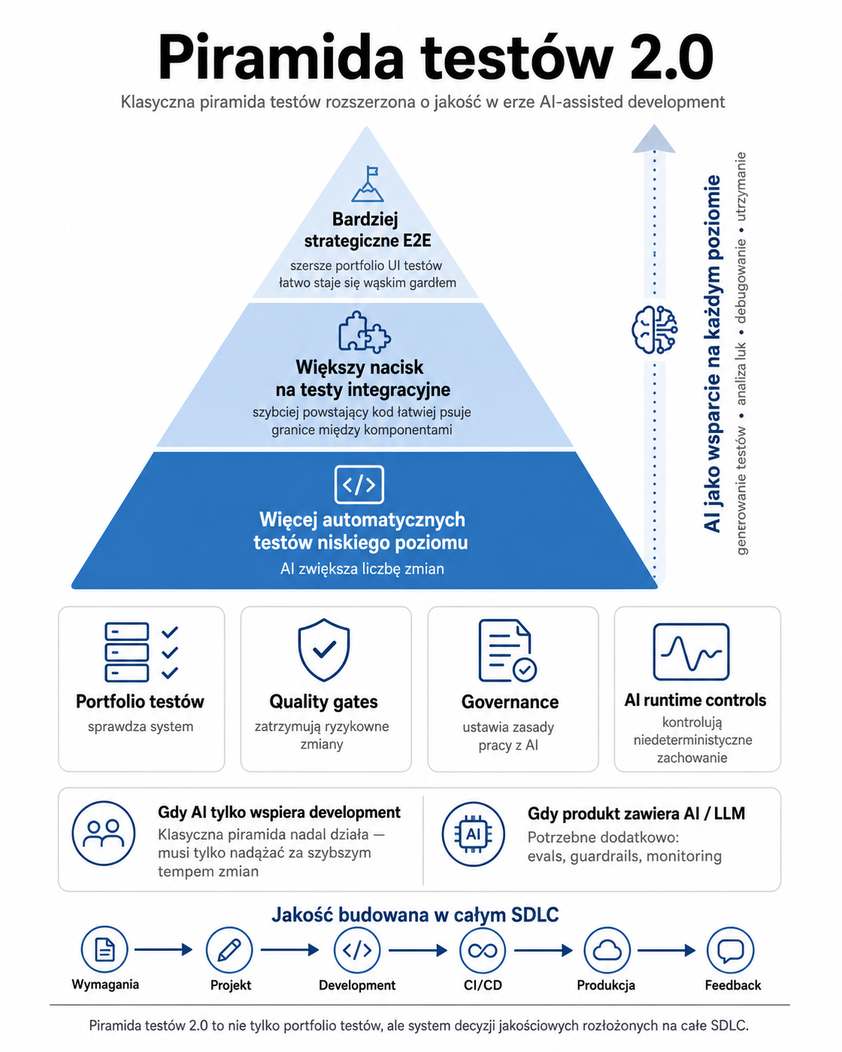
Czym jest Piramida testów 2.0?
W tym ujęciu Piramida testów 2.0 nie oznacza przede wszystkim nowej warstwy dla aplikacji AI. [6][7]
Oznacza raczej, że klasyczna piramida musi zostać dostosowana do świata, w którym AI:
- przyspiesza tworzenie kodu,
- pomaga tworzyć testy,
- zwiększa wolumen zmian,
- wymusza mocniejsze mechanizmy review,
- i sprawia, że szybki feedback jakościowy staje się jeszcze ważniejszy.
Piramida testów 2.0 to klasyczna piramida testów rozszerzona o mechanizmy kontroli jakości wymagane przez AI-assisted development oraz przez produkty zawierające komponenty niedeterministyczne.
Dlatego proponuję rozumieć ją tak:
- Więcej automatycznych testów niskiego poziomu, bo AI zwiększa liczbę zmian.
- Większy nacisk na testy integracyjne, bo szybciej powstający kod łatwiej psuje granice między komponentami.
- Bardziej strategiczne E2E, bo przy większym tempie zmian zbyt szerokie portfolio UI testów szybko staje się wąskim gardłem.
- AI jako wsparcie na każdym poziomie piramidy: generowanie testów, analiza luk, debugowanie i utrzymanie.
- Dodatkowe mechanizmy typu evals i guardrails tylko tam, gdzie w samym produkcie lub workflow pojawia się niedeterministyczność.
Tu warto oddzielić dwie sytuacje.
Jeśli AI pomaga Ci tworzyć software, ale sam produkt pozostaje deterministyczny, klasyczna piramida nadal działa — tylko musi nadążać za szybszym tempem zmian. Jeśli jednak sam produkt zawiera LLM, agenta albo inny niedeterministyczny komponent, wtedy sama piramida nie wystarczy. Potrzebujesz dodatkowo evali, guardrails i monitoringu. [6][8][9][10][19]
Piramida testów 2.0 to nie tylko portfolio testów
W praktyce dyskusja o Piramidzie testów 2.0 bardzo łatwo miesza kilka różnych poziomów myślenia: typy testów, mechanizmy kontroli jakości w pipeline, zasady organizacyjne oraz mechanizmy kontroli systemów AI działających w produkcie.
Dlatego warto rozdzielić cztery osobne warstwy, które razem budują jakość w erze AI-assisted development.
- Portfolio testów – czyli zestaw testów uruchamianych na różnych poziomach systemu, takich jak testy jednostkowe, komponentowe, integracyjne, kontraktowe i end-to-end.
- Quality gates – czyli mechanizmy zatrzymujące słabą zmianę przed przejściem dalej w SDLC, na przykład build, statyczna analiza, security checks, review czy release readiness.
- Governance – czyli organizacyjne zasady bezpiecznego i odpowiedzialnego użycia AI, takie jak polityki pracy z AI, klasyfikacja danych, obowiązkowy review czy kontrola zmian wysokiego ryzyka.
- AI runtime controls – czyli mechanizmy potrzebne wtedy, gdy AI działa już w samym produkcie, na przykład evals, guardrails, monitoring jakości odpowiedzi, tracing i human-in-the-loop.
Portfolio testów służy do sprawdzania systemu, quality gates do zatrzymywania ryzykownych zmian, governance do ustawiania zasad pracy z AI, a AI runtime controls do kontrolowania niedeterministycznego zachowania systemu w samym produkcie.
Piramida testów 2.0 a system quality gates w całym SDLC
W praktyce Piramida testów 2.0 nie powinna być rozumiana wyłącznie jako układ typów testów w fazie developmentu. Największą wartość daje wtedy, gdy staje się częścią szerszego systemu quality gates rozciągniętego na całe SDLC – od discovery i wymagań, przez projektowanie, development i wdrożenie, aż po feedback loop po produkcji.
To ważna zmiana perspektywy. W klasycznym myśleniu często skupialiśmy się głównie na pytaniu: jakie testy uruchomić przed mergem albo release’em?
Dzisiaj to za mało. Jeżeli AI przyspiesza tempo zmian, to jakość trzeba budować wcześniej i szerzej – już na poziomie analizy luk, kompletności wymagań, zgodności architektury, gotowości produkcyjnej i obserwacji zachowania systemu po wdrożeniu.
Innymi słowy, Piramida testów 2.0 nie kończy się na CI. Dobrze działa dopiero wtedy, gdy każda faza przejścia między etapami pracy ma własne, sensowne kryteria wejścia i wyjścia. Dzięki temu zespół nie próbuje “odrobić jakości” dopiero na końcu pipeline’u, ale buduje ją stopniowo – od wymagań aż po produkcję.
Piramida testów 2.0 to nie tylko portfolio testów. To także system decyzji jakościowych rozłożonych na całe SDLC.
Poziom pierwszy Piramidy testów 2.0: testy jednostkowe i komponentowe
Jeśli AI przyspiesza produkcję zmian, to najbardziej rośnie wartość warstwy, która: [1][4]
- działa szybko,
- daje tani feedback,
- jasno wskazuje problem,
- i jest najłatwiejsza do uruchamiania w dużej skali.
Czyli testów jednostkowych i komponentowych.
W świecie AI-assisted development ta warstwa jest ważniejsza z trzech powodów. [6]
Po pierwsze, AI przyspiesza tworzenie kodu.
Skoro kodu pojawia się więcej, potrzebujesz więcej taniej weryfikacji.
Po drugie, AI potrafi generować także testy jednostkowe. [16] To znaczy, że ta warstwa skaluje się dziś łatwiej niż kiedyś – ale tylko wtedy, gdy ktoś pilnuje jakości tych testów.
Po trzecie, ta warstwa najlepiej nadaje się do szybkiego feedback loopa.
A to właśnie szybki feedback jest kluczowy, kiedy zespół pracuje z większą liczbą zmian.
Przykładowo, jeśli AI pomaga wygenerować nową funkcję walidacji, to test jednostkowy jest pierwszym miejscem, w którym możesz zweryfikować:
- poprawność logiki,
- przypadki brzegowe,
- oczekiwane wyjątki,
- zgodność z intencją biznesową.
To właśnie tutaj Piramida 2.0 najmocniej pokazuje swój sens:
AI nie zmniejsza znaczenia testów niskiego poziomu. AI sprawia, że stają się one jeszcze bardziej opłacalne.
Poziom drugi Piramidy testów 2.0: testy integracyjne są kluczowe
AI nie generuje wyłącznie pojedynczych funkcji. Coraz częściej wspomaga tworzenie kompletnych rozwiązań:
- składanie całych endpointów,
- tworzenie komponentów,
- modyfikowanie kontraktów,
- implementowanie nowych integracji,
- refaktoryzowanie przepływów danych.
A właśnie tam bardzo łatwo o subtelne błędy.
Dlatego testy integracyjne i kontraktowe zyskują na znaczeniu. To one sprawdzają, czy różne części systemu nadal współpracują ze sobą poprawnie. [1][6]
To szczególnie ważne w projektach, gdzie AI wspiera developerów przy większych zmianach. Kod może wyglądać sensownie, a nawet przechodzić lokalne testy jednostkowe, ale dopiero integracja pokaże, że:
- kontrakt API się rozjechał,
- mapper działa źle,
- serializacja się zmieniła,
- retry policy powoduje nieoczekiwane skutki,
- zależność zewnętrzna jest obsłużona niezgodnie z wymaganiem.
W praktyce AI-assisted development bardzo zwiększa wartość pytania:
czy nasze granice systemu są dobrze chronione?
Poziom trzeci Piramidy testów 2.0: E2E w erze AI
Wiele zespołów, kiedy widzi szybsze tempo zmian, wpada w pułapkę:
dołóżmy więcej E2E, bo one sprawdzą wszystko! [5]
To zwykle prowadzi do odwrotnego efektu. Jeżeli AI przyspiesza development, a Ty odpowiesz na to głównie większą liczbą wolnych testów UI, to szybko zablokujesz własny pipeline.
Dlatego w wersji 2.0 E2E nadal są potrzebne, ale powinny pozostać:
- ograniczone liczbowo,
- strategiczne,
- skupione na najważniejszych ścieżkach biznesowych.
Ich rola nie polega na tym, żeby kompensować brak testów niższych warstw.
Ich rola polega na tym, żeby potwierdzać, że najważniejsze przepływy nadal działają z perspektywy użytkownika. [1][6]
To jeszcze ważniejsze wtedy, gdy część kodu, testów lub refaktoryzacji powstaje z udziałem AI.
Piramida testów 2.0: gdzie w tym wszystkim jest miejsce na AI?
W kontekście piramidy testów 2.0 najlepiej myśleć o AI w trzech rolach. Każda z nich ma inny wpływ na poziomy piramidy testów i inny zestaw wyzwań.
Zanim przejdziemy dalej, warto bardzo wyraźnie rozdzielić dwie różne sytuacje. Pierwsza: AI pomaga wytwarzać software, ale sam produkt pozostaje deterministyczny. Druga: AI staje się częścią produktu, więc w samym systemie pojawia się niedeterministyczność odpowiedzi albo działań.
To rozróżnienie ma ogromne znaczenie, bo w pierwszym przypadku najczęściej wystarczy wzmocniona klasyczna piramida – szybszy feedback, lepszy review, sensowne quality gates i mocniejsze guardraile procesu. Natomiast w drugim przypadku sama piramida już nie wystarcza i trzeba dołożyć dodatkowe mechanizmy oceny, takie jak evals, guardrails runtime, monitoring jakości odpowiedzi i obserwacja zachowania agentów.
Innymi słowy: nie każde użycie AI oznacza automatycznie potrzebę evals. Evals stają się potrzebne dopiero wtedy, gdy niedeterministyczność trafia do samego produktu, a nie tylko do workflow zespołu.
Rola 1: AI wspierające tworzenie i utrzymanie testów
To dziś najbardziej uniwersalny przypadek: [6][16]
- generowanie szkiców testów,
- podpowiadanie przypadków brzegowych,
- debugowanie failing tests,
- poprawki flaky tests,
- tworzenie danych testowych,
- analiza luk w coverage.
AI może tu naprawdę zwiększyć produktywność i jakość. Ale nadal jest to wsparcie dla klasycznej piramidy, a nie jej zastępstwo.
Jakie są wyzwania?
- jakość wygenerowanych testów,
- utrzymanie testów generowanych przez AI,
- wiedza techniczna i biznesowa potrzebna do oceny tych testów,
- koszt utrzymania większej liczby testów,
- potencjalna nadprodukcja testów, która może prowadzić do problemów z utrzymaniem,
- i konieczność review, aby upewnić się, że testy naprawdę sprawdzają to, co powinny.
Rola 2: AI jako źródło nowego ryzyka w procesie developmentu
Tutaj wchodzą takie kwestie jak:
- pozornie poprawny kod,
- źle zrozumiane wymaganie,
- wygenerowane zależności,
- niezgodność z architekturą,
- większy wolumen zmian niż zespół jest w stanie dobrze sprawdzić ręcznie.
AI nie jest magicznym rozwiązaniem. Bez odpowiednich mechanizmów kontroli i weryfikacji może zwiększyć ryzyko bardziej niż wspomóc proces. [7][15][17]
Rola 3: AI jako komponent produktu
To dopiero tutaj wchodzimy w świat:
- evals, czyli ewaluacji jakości odpowiedzi,
- guardrails, czyli mechanizmów zapobiegających niepożądanym zachowaniom,
- monitoring, czyli monitoringu jakości odpowiedzi,
- ocena agentów (jeśli mamy agentów w produkcie),
- bezpieczeństwo outputów oraz zarządzania zaufaniem do systemu.
To ważny temat, ale to już bardziej osobna warstwa, potrzebna wtedy, gdy aplikacja sama zawiera niedeterministyczne komponenty AI. Wtedy klasyczne testy nadal są potrzebne do sprawdzania logiki biznesowej. Jednak dodatkowo potrzebujesz mechanizmów oceny jakości odpowiedzi, które uwzględniają zmienność i ryzyko związane z AI. [9][10][11][13][14][19][20]
Czy evals są niezbędnym dodatkiem do piramidy testów 2.0?
Najkrótsza i najbardziej praktyczna odpowiedź brzmi: nie zawsze.
Evals nie są obowiązkowym dodatkiem do każdego projektu tylko dlatego, że zespół korzysta z AI podczas developmentu. Są potrzebne przede wszystkim wtedy, gdy oceniasz zachowanie komponentu niedeterministycznego (czyli takiego, którego zachowanie może się różnić przy kolejnych uruchomieniach) – na przykład modelu językowego, agenta, klasyfikatora albo systemu generującego treść. W takich sytuacjach klasyczne porównanie typu expected === actual często nie wystarcza do sensownej oceny jakości. [9][10][11]
Oficjalne materiały OpenAI pokazują evals jako sposób systematycznego testowania jakości modeli i aplikacji opartych na modelach, a Google Cloud opisuje Gen AI evaluation service jako narzędzie do obiektywnej, data-driven oceny modeli i aplikacji generatywnych. To dobrze pokazuje różnicę względem tradycyjnych testów. Nie zawsze chodzi o jeden z góry ustalony wynik, ale raczej o ocenę jakości odpowiedzi względem określonych kryteriów, danych i ryzyk. [10][22]
Warto też wyraźnie oddzielić evals od guardrails. Evals służą do mierzenia jakości i porównywania zachowania systemu, natomiast guardrails mają ograniczać niepożądane akcje lub odpowiedzi w czasie działania systemu. OpenAI opisuje guardrails jako mechanizmy sprawdzające wejście i wyjście agenta oraz zatrzymujące wykonanie, gdy wykryją problem. To znaczy, że evals pomagają ocenić “jak dobrze działa system?”, a guardrails pomagają pilnować “czego system nie powinien zrobić?”. [19][23]
Z perspektywy Piramidy testów 2.0 najważniejszy wniosek jest taki:
evals nie zastępują testów jednostkowych, integracyjnych ani E2E. Są dodatkową warstwą oceny tylko tam, gdzie sam system przestaje być w pełni deterministyczny.
Jeśli AI pomaga Ci pisać kod, ale produkt końcowy pozostaje zwykłą aplikacją biznesową, nadal najwięcej wartości dostarczy klasyczna piramida. Jeśli jednak produkt zawiera model, agenta lub generowanie odpowiedzi, wtedy evals stają się bardzo sensownym rozszerzeniem strategii jakości. [1][6][10][22]
Governance: organizacyjne zasady jakości w erze AI
Wiele osób myśli o jakości w erze AI głównie technicznie: testy, evals, review, pipeline. To wszystko jest ważne, ale w praktyce równie istotne są guardraile organizacyjne. Jeżeli zespół nie ma jasnych zasad używania AI, nie wie jakie dane może przekazywać do modeli, nie rozróżnia zmian niskiego i wysokiego ryzyka albo nie ma ustalonego procesu human review, to nawet dobry pipeline nie rozwiąże wszystkich problemów.
Dlatego Piramida testów 2.0 najlepiej działa tam, gdzie istnieją także zasady dotyczące:
- używania AI w projekcie,
- klasyfikacji danych i ograniczeń bezpieczeństwa,
- obowiązkowego review zmian wygenerowanych przez AI,
- pracy z kodem i zależnościami o wysokiej wrażliwości,
- oraz kontroli nad tzw. shadow AI, czyli nieformalnym używaniem narzędzi poza uzgodnionym procesem.
To pokazuje, że jakość nie zależy wyłącznie od tego, czy uruchomisz test, ale także od tego, w jakim systemie pracy ten test funkcjonuje. AI przyspiesza produkcję zmian, więc organizacja musi równie świadomie zarządzać zaufaniem, ryzykiem i odpowiedzialnością za decyzje techniczne.
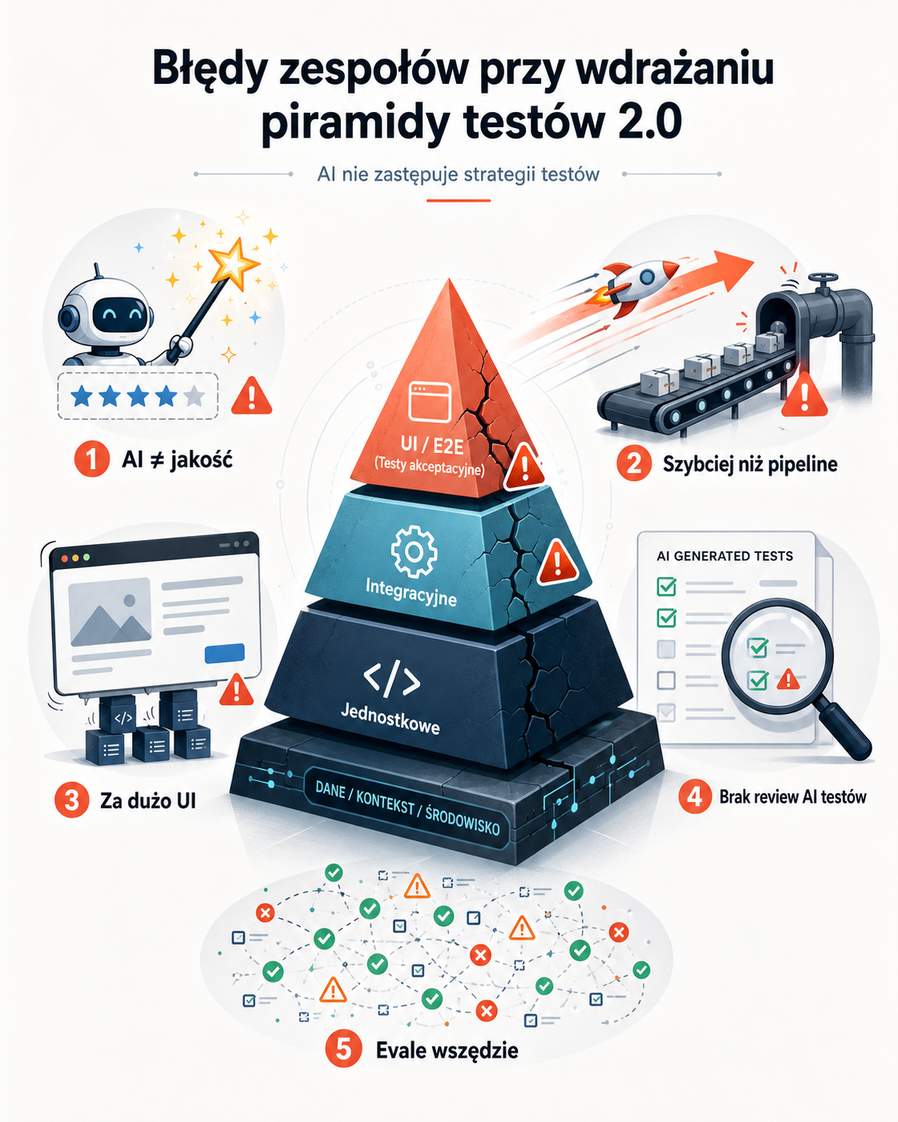
Błędy zespołów przy wdrażaniu piramidy testów 2.0
Traktowanie AI jako magicznej różdżki do jakości
AI może przyspieszyć pisanie kodu i testów, ale nie zastępuje architektury testów, review ani odpowiedzialności za zmianę. Na poczatku warto uruchamiać testy i statyczną analizę najpierw, a potem dopiero dalszą ocenę kodu. Jeśli zespół zaczyna polegać wyłącznie na AI, szybko straci kontrolę nad jakością i stabilnością. [15][7]
Zwiększanie tempa zmian bez wzmacniania pipeline’u
Jeśli Twój pipeline nie jest w stanie szybko i skutecznie weryfikować rosnącej liczby zmian, zespół szybko zacznie mieć problemy z błędami, regresjami i niestabilnością. To błąd zduplikowania szybkości bez jakości. [7][18]
Zawierzanie zbyt wiele testom interfejsu zamiast testom niskiego poziomu
Wielu zespołów odpowiada na szybsze tempo zmian głównie większą liczbą wolnych testów UI – to klasyczna pułapka. Takie podejście szybko zablokuje pipeline. E2E mają rolę, ale nie mogą być główną obstawą w erze szybkich zmian. [5][6]
Brak przeglądu testów wygenerowanych przez AI
Test wygenerowany przez model czasami wygląda poprawnie, ale w praktyce nie sprawdza istotnych aspektów funkcjonalności. Schematy powielają się, ważne przypadki brzegowe są pomijane, a test potwierdzać może jedynie implementację zamiast realnie jej sprawdzać. Dlatego review testów generowanych przez AI jest równie ważne jak review kodu. [15][16]
Wrzucanie evali wszędzie
Evals są potrzebne, ale tylko tam, gdzie masz niedeterministyczne zachowanie. W zwykłej logice biznesowej nadal wygrywają klasyczne testy. Dodawanie evals do każdego testu tylko dlatego, że “mamy AI” to nadmiar, który zwiększa koszt utrzymania testów bez proporcjonalnej wartości. Evals powinny być stosowane tam, gdzie klasyczne expected === actual nie wystarcza do oceny jakości odpowiedzi lub zachowania systemu. [9][10][13]
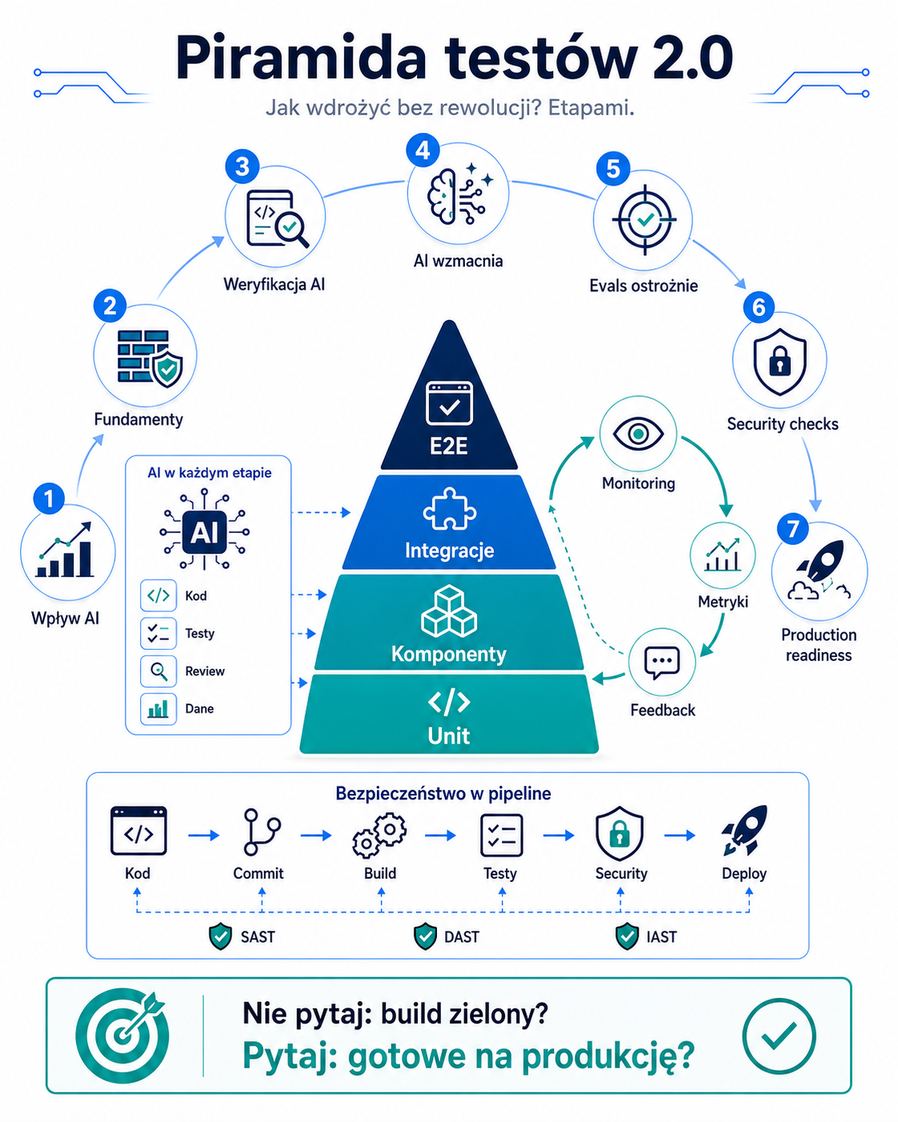
Jak wdrożyć piramidę testów 2.0 bez rewolucji?
Najlepiej etapami.
Krok 1: Zmierz rzeczywisty wpływ AI na Twój workflow
Sprawdź, czy AI wspomaga: [7]
- pisanie kodu,
- generowanie testów,
- refaktoryzacje,
- analizę bugów,
- tworzenie danych testowych.
Krok 2: Wzmocnij fundamenty – dolne warstwy piramidy
Jeśli liczba zmian rośnie, zadbaj najpierw o: [6]
- szybkie testy jednostkowe,
- sensowne testy komponentowe,
- integracje krytycznych granic,
- krótkie czasy feedbacku.
Krok 3: Traktuj kod generowany przez AI jak materiał do weryfikacji
Review, testy, statyczna analiza i zgodność z architekturą pozostają obowiązkowe. [15]
Krok 4: Posługuj się AI do wzmacniania piramidy, nie do jej omijania
Najlepsze zastosowania AI to zwykle: [16][6]
- generowanie pierwszych szkiców testów,
- identyfikacja brakujących przypadków testowych,
- refaktoryzacja i konserwacja,
- debugowanie awarii,
- analiza testów podatnych na niepowodzenia.
Krok 5: Dodaj evals ostrożnie, tylko gdzie są potrzebne
Jeżeli w samym produkcie masz modele, agentów albo inny niedeterministyczny komponent, wtedy dołóż evals, guardrails i monitoring. [10][19]
Krok 6: Uzupełnij pipeline o security checks
Jeżeli AI przyspiesza tworzenie zmian, warto zadbać również o automatyczne mechanizmy bezpieczeństwa. SAST pomaga wychwycić część problemów już na poziomie kodu, DAST pozwala badać działającą aplikację, a IAST może dać dodatkowy wgląd w podatności ujawniające się podczas wykonywania aplikacji. To nie zastępuje testów jednostkowych, integracyjnych ani E2E, ale wzmacnia cały pipeline jakościowy o perspektywę bezpieczeństwa.
Krok 7: Nie kończ jakości na zielonych buildach
W klasycznym myśleniu zespół często traktował zielony pipeline jako główny sygnał, że zmiana jest gotowa. W erze AI to już za mało. Green build nie oznacza jeszcze gotowości produkcyjnej, a tym bardziej nie gwarantuje, że po wdrożeniu nie pojawią się opóźnione skutki uboczne.
Dlatego Piramida testów 2.0 powinna obejmować także etap gotowości produkcyjnej oraz feedback loop po wdrożeniu. W praktyce oznacza to między innymi sprawdzenie, czy system jest bezpieczny do wypuszczenia, czy obserwowalność jest wystarczająca, czy guardraile działają poprawnie i czy zespół monitoruje błędy oraz regresje nie tylko w dniu release’u, ale także po 30, 60 i 90 dniach.
To bardzo ważne zwłaszcza wtedy, gdy AI zwiększa tempo zmian. Przy większej liczbie zmian więcej problemów może ujawniać się dopiero po czasie: pod obciążeniem, przy nietypowych danych, po zmianie zachowań użytkowników albo w połączeniu z innymi wdrożeniami. Dlatego dobra strategia jakości nie kończy się na pytaniu:
czy pipeline jest zielony?
Lepiej zapytać:
czy ta zmiana jest naprawdę gotowa na produkcję i czy umiemy szybko zauważyć skutki uboczne po wdrożeniu?
Po czym poznać, że Piramida testów 2.0 działa?
W erze AI bardzo łatwo pomylić więcej aktywności z lepszą jakością. Można generować więcej testów, więcej pull requestów, więcej commitów i więcej zmian, a mimo to nie poprawiać stabilności systemu. Dlatego Piramidę testów 2.0 warto oceniać nie po ilości artefaktów, ale po tym, czy rzeczywiście lepiej chroni przed regresją.
W praktyce warto obserwować takie wskaźniki jak:
- defect escape rate – czyli ile problemów przedostaje się na wyższe środowiska lub produkcję,
- mutation score – który lepiej niż sam coverage pokazuje, czy testy naprawdę wykrywają błędy,
- false positive rate – szczególnie tam, gdzie AI pomaga w review albo analizie zmian,
- AI rework ratio – czyli ile wygenerowanej pracy trzeba później poprawiać ręcznie,
- czas przejścia zmian przez pipeline,
- oraz trendy defektów po 30, 60 i 90 dniach od wdrożenia.
To bardzo ważne, bo w świecie AI nie wystarczy powiedzieć: mamy więcej testów. Lepsze pytanie brzmi:
czy mamy lepszą jakość i czy szybciej odróżniamy dobrą zmianę od złej?
Właśnie dlatego same metryki aktywności, takie jak liczba commitów, liczba linii kodu czy liczba wygenerowanych testów, mogą być mylące. AI potrafi je łatwo napompować. Natomiast sensowna strategia jakości powinna pokazywać, czy system jest stabilniejszy, czy ryzyko spada i czy zespół podejmuje lepsze decyzje przed wdrożeniem.
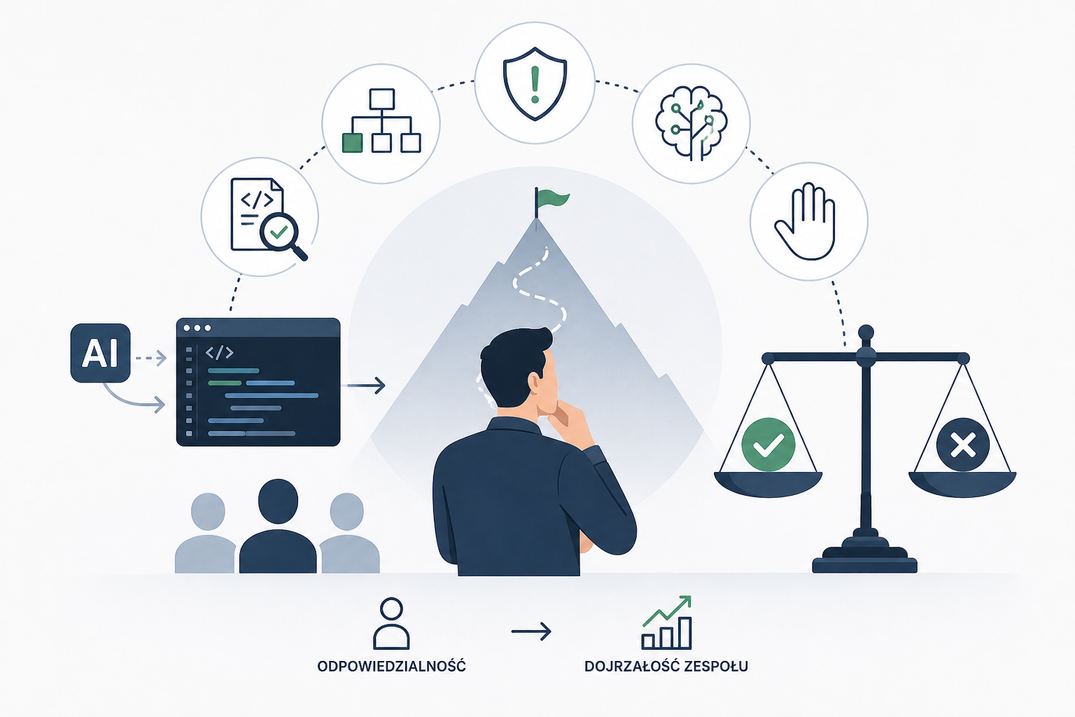
Piramida testów 2.0 wymaga też nowych kompetencji zespołu
Warto podkreślić, że przejście do Piramidy testów 2.0 nie polega wyłącznie na dodaniu nowych narzędzi. To także zmiana kompetencyjna. Zespół musi dziś lepiej radzić sobie z oceną jakości wygenerowanego kodu, rozbijaniem problemów na sensowne zadania, precyzyjnym formułowaniem kontekstu oraz odróżnianiem szybkiej odpowiedzi modelu od rzeczywiście dobrej decyzji inżynierskiej.
W praktyce oznacza to, że rośnie znaczenie takich umiejętności jak:
- krytyczny review wygenerowanego kodu i testów,
- rozumienie architektury i granic systemu,
- lepsza analiza ryzyka,
- świadome użycie AI tylko tam, gdzie naprawdę daje wartość,
- oraz umiejętność zatrzymania automatyzacji wtedy, gdy koszt błędu byłby zbyt duży.
To dlatego najważniejsza zmiana nie dotyczy wyłącznie technologii. Dotyczy także ludzi i sposobu podejmowania decyzji. AI nie usuwa odpowiedzialności z zespołu. AI podnosi wymagania wobec dojrzałości zespołu.
Najważniejsza zmiana nie jest techniczna, tylko organizacyjna i mentalna
Najważniejsza lekcja z AI-assisted development nie brzmi:
AI napisze za nas testy
Wbrew oczekiwaniom, przekaz brzmi:
AI przyspiesza pracę, więc jeszcze bardziej potrzebujemy systemu, który szybko odróżnia dobrą zmianę od złej.
To spostrzeżenie potwierdza DORA (DevOps Research and Assessment), która pokazuje, że sukces AI nie jest tylko problemem narzędziowym, ale systemowym. W praktyce, AI daje najlepsze efekty tam, gdzie istnieją już stabilne i dojrzałe praktyki inżynierskie, dobrze skonfigurowana platforma CI/CD, wersjonowanie, review i automatyczne testy. [7][18]
Wynika stąd zasadnicza obserwacja: piramida testów nie traci dziś sensu.
Przeciwnie – staje się jeszcze ważniejsza.
Przyczyna jest prosta: jeśli AI zwiększa liczbę zmian, to potrzebujesz jeszcze lepszego mechanizmu:
- szybkiego feedbacku,
- kontroli ryzyka,
- sensownego doboru poziomów testów,
- i świadomego użycia automatyzacji.
Podsumowanie
Klasyczna piramida testów nie umarła – to byłby błędny wniosek.
W erze AI-assisted development nie chodzi o jej porzucenie, ale przede wszystkim o zmianę perspektywy przy jej zastosowaniu.
Najważniejsze pytanie nie brzmi już tylko tradycyjnie:
jak testować aplikacje z AI?
Przesunęło się ono w znacznie bardziej praktycznym kierunku:
jak utrzymać jakość, gdy AI przyspiesza samo wytwarzanie oprogramowania?
Moja odpowiedź brzmi konkretnie następująco:
Piramida testów 2.0 to nadal: [6][7]
- dużo szybkich testów niskiego poziomu,
- sensowne testy integracyjne,
- niewielka liczba strategicznych E2E,
ale dodatkowo powinniśmy uwzględnić:
- AI pomaga tworzyć i utrzymywać testy,
- AI zwiększa tempo zmian, więc rośnie znaczenie szybkiego feedbacku,
- review i weryfikacja AI-generated code stają się krytyczne,
- a evals i guardrails dokładamy wtedy, gdy w samym systemie pojawia się niedeterministyczny komponent AI. [9][19]
To właśnie w tym sensie piramida testów 2.0 jest dziś potrzebna.
Nie dlatego, że klasyczna była błędna.
Tylko dlatego, że AI zmienia sposób, w jaki budujemy, zmieniamy i weryfikujemy software.
Źródła
- [1] Martin Fowler, Test Pyramid
https://martinfowler.com/articles/practical-test-pyramid.html - [2] Ham Vocke, The Practical Test Pyramid
https://martinfowler.com/articles/practical-test-pyramid.html - [3] Martin Fowler, On the Diverse And Fantastical Shapes of Testing
https://martinfowler.com/articles/2021-test-shapes.html - [4] Google Testing Blog, Test Sizes
https://testing.googleblog.com/2010/12/test-sizes.html - [5] Google Testing Blog, Just Say No to More End-to-End Tests
https://testing.googleblog.com/2015/04/just-say-no-to-more-end-to-end-tests.html - [6] Priyank Desai, Snahil Singh, Shubham Amilkanthwar, The Test Pyramid 2.0: AI-assisted testing across the pyramid, Frontiers in Artificial Intelligence, 2025
https://www.frontiersin.org/journals/artificial-intelligence/articles/10.3389/frai.2025.1695965/full - [7] DORA, State of AI-assisted Software Development 2025
https://dora.dev/research/2025/dora-report/ - [8] EPAM, Reimagining the Testing Pyramid for GenAI Applications
https://www.epam.com/insights/ai/blogs/reimagining-testing-pyramid-for-genai-applications - [9] OpenAI, Evaluation best practices
https://platform.openai.com/docs/guides/evaluation-best-practices - [10] OpenAI, Working with evals
https://platform.openai.com/docs/guides/evals - [11] OpenAI, Agent evals
https://platform.openai.com/docs/guides/agent-evals - [12] OpenAI, Evaluating model performance
https://platform.openai.com/docs/guides/evals#evaluating-model-performance - [13] NIST, AI Risk Management Framework (AI RMF 1.0)
https://www.nist.gov/itl/ai-risk-management-framework - [14] NIST, Generative AI Profile
https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - [15] GitHub Docs, Review AI-generated code
https://docs.github.com/en/copilot/tutorials/review-ai-generated-code - [16] GitHub Docs, Write tests with GitHub Copilot
https://docs.github.com/en/copilot/tutorials/write-tests - [17] Martin Fowler, Exploring GenAI
https://martinfowler.com/articles/exploring-gen-ai.html - [18] Google Research, DORA 2025: State of AI-assisted software development
https://research.google/pubs/dora-2025-state-of-ai-assisted-software-development-report/ - [19] OpenAI, Building guardrails for agents
https://openai.github.io/openai-agents-python/guardrails/ - [20] Google Cloud, Evaluate generative AI models and applications
https://cloud.google.com/vertex-ai/generative-ai/docs/evaluate/overview - [21] OpenAI Agents SDK, Human-in-the-loop
https://openai.github.io/openai-agents-python/human_in_the_loop - [22] Google Cloud Vertex AI, Gen AI evaluation service overview
https://docs.cloud.google.com/vertex-ai/generative-ai/docs/models/evaluation-overview - [23] OpenAI Agents SDK, Guardrails
https://openai.github.io/openai-agents-python/guardrails/ - [24] OpenAI Agents SDK, Overview
https://openai.github.io/openai-agents-python/ - [25] Nexocode, The Agentic AI Maturity Model: Crawl, Walk, Run, Scale
https://nexocode.com/blog/posts/the-agentic-ai-maturity-model-crawl-walk-run-scale/ - [26] MIT Sloan Management Review, What’s Your Company’s AI Maturity Level?
https://mitsloan.mit.edu/ideas-made-to-matter/whats-your-companys-ai-maturity-level - [27] Appinventiv, AI Maturity Model: Levels, Framework & Assessment
https://appinventiv.com/blog/ai-maturity-assessment/ - [28] OWASP, AI Maturity Assessment Framework
https://owasp.org/www-project-ai-maturity-assessment/ - [29] Modele Dojrzałości AI
https://jaktestowac.pl/modele-dojrzalosci-ai/
|
|
||
|
|||
