
Agent AI może napisać kod. Ale skąd wie, że zrobił to dobrze? Feedback loop w praktyce
Wyobraź sobie agenta AI, który ma dostęp do repozytorium, terminala, przeglądarki, dokumentacji i pipeline’u CI/CD. Może analizować kod, implementować nowe funkcje, naprawiać błędy i uruchamiać testy. Może nawet przygotować pull request i zaproponować jego wdrożenie.
Skąd agent ma wiedzieć, że zmiana, którą właśnie wprowadził, rzeczywiście rozwiązuje problem?
Że nie popsuł czegoś innego? Że poprawił wydajność, a nie tylko wynik benchmarku? Że zielone testy oznaczają poprawne działanie systemu, a nie błędne założenia zapisane w asercjach?
Moim zdaniem to jedno z ciekawszych pytań związanych z rozwojem agentów AI. Przy projektowaniu frameworków testowych UI i API oraz tworzeniu aplikacji z pomocą agentów coraz częściej widzę, że samo generowanie kodu przestaje być największym wyzwaniem. Trudniejsze zaczyna się krok później. Dużo rozmawiamy o kolejnych modelach, narzędziach, MCP, skills i coraz większej autonomii. Znacznie mniej o tym, jak agent ma sprawdzać efekty własnej pracy i podejmować decyzje na podstawie tego, co zobaczył. A samo wykonanie zadania nie oznacza jeszcze, że zostało wykonane poprawnie.
Do tego służą feedback loops, czyli pętle informacji zwrotnej: mechanizmy, dzięki którym agent może nie tylko wykonać zmianę, ale też zaobserwować jej rezultat, porównać go z oczekiwaniem i zdecydować, czy kontynuować pracę, poprawić rozwiązanie, czy przekazać problem człowiekowi.
Czego dowiesz się z tego artykułu?
- Jak Anthropic wykorzystał agentów AI, benchmarki i telemetrykę do optymalizacji claude.ai.
- Czym różnią się narzędzia do działania od mechanizmów obserwacji i kontroli.
- Dlaczego szybkość, wiarygodność i jakość informacji zwrotnej mają bezpośredni wpływ na użyteczność agentów.
- Jak sprawdzić, czy sam test (sensor) jest wiarygodny i co zrobić, gdy błąd tkwi w mechanizmie oceny.
- Co zrobić, żeby agent nie optymalizował błędnych metryk albo nie poprawiał testów tylko po to, żeby stały się zielone.
- Jak połączyć testy automatyczne, observability, evals i guardrails w jeden praktyczny proces.
- Od czego uzależnić zakres autonomii agenta.
- Czym jest dług weryfikacyjny i co to wszystko oznacza dla QA, Quality Engineering i Test Architektów.
Jeśli chcesz praktycznie rozwijać umiejętności związane z AI w testowaniu, sprawdź też AI_Testers (aitesters.pl) – program, który został przygotowany z myślą o wykorzystaniu AI w pracy testerów, automatyzacji i nowoczesnym podejściu do jakości.
Przykład Anthropic: 3 razy szybciej w dwa tygodnie
Punktem wyjścia był dla mnie materiał Anthropic opublikowany 23 września 2026 roku: How we made claude.ai 3x faster in two weeks.
Anthropic opisuje w nim dwutygodniowy eksperyment, w którym zespół, intensywnie korzystając z Claude, poprawił wydajność kluczowych ścieżek użytkownika w claude.ai i aplikacji desktopowej. Nie chodziło przy tym wyłącznie o syntetyczne benchmarki. Zespół analizował rzeczywiste ścieżki użytkowników i ich czasy wykonania.
Według opublikowanych wyników czas do uzyskania interaktywnej strony przy świeżym uruchomieniu claude.ai spadł z 3,1 s do 0,55 s (75. percentyl). Dla całego zestawu optymalizowanych doświadczeń Anthropic oszacował poprawę na około 3x. W trakcie eksperymentu połączono też ponad 3000 zmian, według relacji zespołu bez incydentów odczuwalnych przez klientów i bez rollbacków.
Wyniki robią wrażenie, choć opisuje je sam Anthropic i dotyczą jednego projektu, zespołu i środowiska.
Mnie jednak bardziej niż same liczby zainteresowało co innego: w jaki sposób udało się przeprowadzić tak wiele zmian, nie tracąc kontroli nad ich skutkami?
Agent nie tylko zmieniał kod. Musiał udowodnić poprawę.
Claude nie dostał zadania “przyspiesz aplikację”, po którym wygenerowałby jeden wielki pull request. Proces wyglądał inaczej:
- Zespół identyfikował problem widoczny w konkretnej ścieżce użytkownika.
- Claude analizował kod, telemetrykę i potencjalne przyczyny.
- Budował lub wykorzystywał benchmark, który pozwalał odtworzyć problem.
- Przygotowywał zmianę i sprawdzał jej efekt.
- Zespół oceniał rozwiązanie i zatwierdzał wdrożenie.
- Po wdrożeniu Claude analizował rzeczywiste dane.
- Jeśli poprawa została potwierdzona, dodawano zabezpieczenie przed regresją. Jeśli nie, zmiana mogła zostać cofnięta przez feature flag i proces rozpoczynał się ponownie.
Pracy nie kończono więc na zielonym teście ani poprawnym buildzie. Wynik z benchmarku był potem konfrontowany z danymi zebranymi po wdrożeniu.
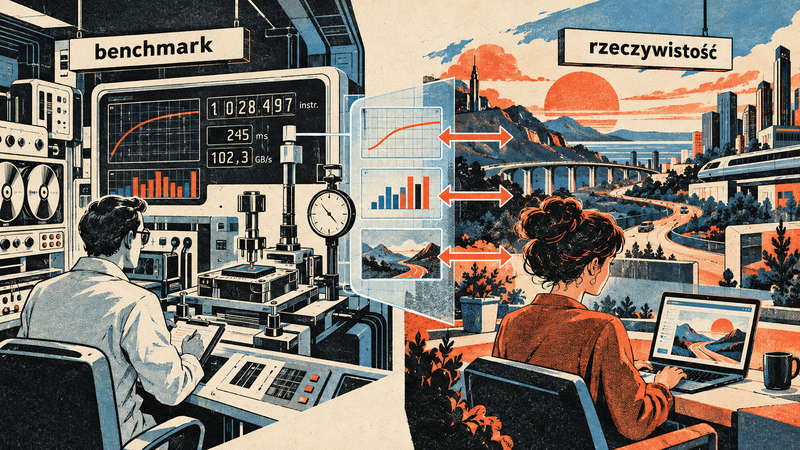
Najciekawszy element: benchmark też musiał przejść weryfikację
Rzeczywisty czas wykonania operacji dobrze opisuje doświadczenie użytkownika, ale bywa niestabilny. Różnic rzędu pojedynczych milisekund trudno użyć jako niezawodnego Quality Gate.
Zespół zaczął więc eksperymentować z innymi sygnałami, takimi jak:
- liczba instrukcji wykonywanych przez procesor,
- liczba renderowań komponentów React,
- liczba zmian w DOM,
- liczba przeliczeń stylów,
- liczba wywołań funkcji.
Takie pomiary bywają bardziej deterministyczne i tańsze niż odtwarzanie pełnego scenariusza użytkownika. Mają jednak swoją pułapkę: to, że zmniejszyliśmy liczbę instrukcji, nie oznacza automatycznie, że użytkownik dostał szybszą aplikację.
Anthropic wymagał więc potwierdzenia, że poprawa danego benchmarku przekłada się na rzeczywistą poprawę czasu wykonania. W jednym z opisanych przypadków redukcja liczby instrukcji o 48% i 31% w dwóch badanych ścieżkach przełożyła się odpowiednio na redukcję czasu wykonania o 78% i 44%. Dopiero wtedy benchmarki stawały się zabezpieczeniem przed przyszłymi regresjami. Jeśli pomiar był niestabilny albo nie odpowiadał rzeczywistemu problemowi, zespół go odrzucał.
To dla mnie jeden z najważniejszych wniosków z całego eksperymentu: agent potrzebuje nie tylko czegoś, co potrafi zmierzyć. Potrzebuje pomiaru, któremu można zaufać.
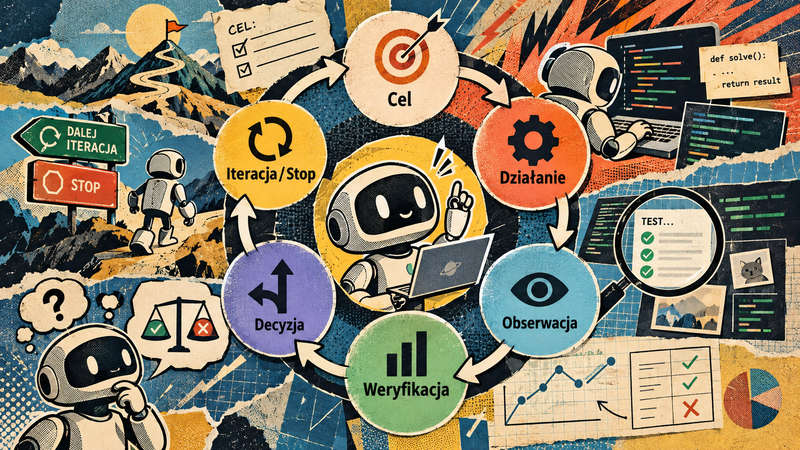
Czym jest pętla informacji zwrotnej agenta AI?
W uproszczeniu to proces, w którym rezultat działania agenta wraca do niego jako informacja potrzebna do podjęcia kolejnej decyzji. Można go zapisać tak:
Cel → Działanie → Obserwacja → Weryfikacja → Decyzja → Kolejna iteracja lub zatrzymanie
Przykładowo:
- Agent otrzymuje zadanie poprawy wydajności endpointu.
- Analizuje implementację i przygotowuje zmianę.
- Uruchamia benchmark, który porównuje wynik z wcześniejszą wersją.
- Sprawdza, czy testy funkcjonalne nadal przechodzą.
- Na podstawie wyników decyduje, czy kontynuować optymalizację.
- Jeżeli rezultat jest niejednoznaczny, powinien zatrzymać pracę lub poprosić człowieka o ocenę.
Sama informacja, że zadanie zostało wykonane, nie wystarczy. Agent potrzebuje informacji o jakości rezultatu.
Przy agentach kodujących (coding agents) widać to szczególnie wyraźnie. Mogą one wykonać dziesiątki zmian w czasie, w którym człowiek przeanalizowałby dopiero część problemu. Jeśli jednak każda kolejna decyzja opiera się na błędnym założeniu, tempo generowania kodu tylko zwiększa skalę problemu.
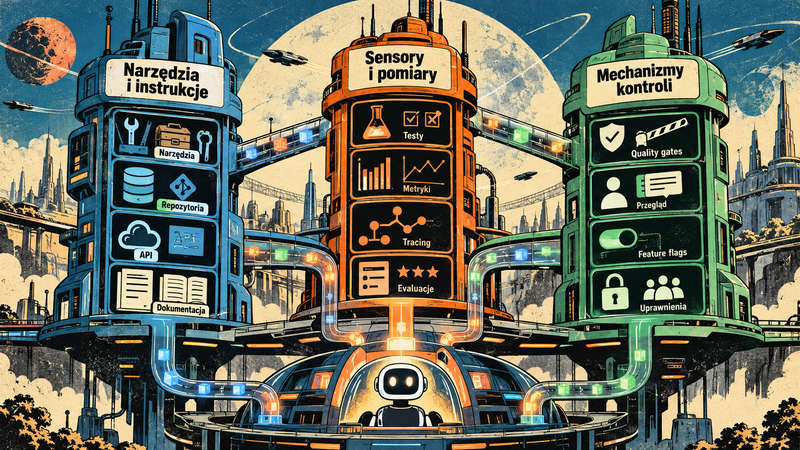
Trzy elementy środowiska pracy agenta
Birgitta Böckeler w artykule Harness engineering for coding agent users, opublikowanym na martinfowler.com, proponuje podział na dwa mechanizmy:
Guides (feedforward) – instrukcje i ograniczenia, które wpływają na zachowanie agenta przed wykonaniem pracy.
Sensors (feedback) – mechanizmy obserwujące rezultaty jego działań i pomagające mu korygować błędy.
Ten podział dobrze porządkuje temat. Ja rozszerzyłbym go jeszcze o trzeci element: reguły podejmowania decyzji, czyli określenie, co agent może zrobić z otrzymaną informacją.
| Element | Przykłady | Rola |
| Narzędzia i instrukcje | Repozytorium, terminal, API, MCP, AGENTS.md, dokumentacja | Umożliwiają wykonanie pracy i określają sposób działania |
| Sensory i pomiary | Testy, lint, type checker, benchmarki, tracing, metryki, evals | Dostarczają informacji o wyniku |
| Mechanizmy kontroli | Quality Gates, limity prób, review, feature flags, uprawnienia | Decydują, czy agent może poprawiać, kontynuować lub wdrożyć zmianę |
Wyobraźmy sobie agenta, który po uruchomieniu testów widzi błąd. Może poprawić implementację. Może uruchomić test ponownie. Może też zmienić sam test, wyłączyć asercję albo zwiększyć timeout. Wszystkie te działania mogą doprowadzić do zielonego wyniku, ale nie wszystkie oznaczają rozwiązanie problemu.
Dlatego sensowna pętla feedbacku potrzebuje nie tylko sygnału, ale również granic tego, jak agent może na niego reagować.
Test jako sensor. Dlaczego jego jakość staje się jeszcze ważniejsza?
W tradycyjnym workflow test automatyczny był przede wszystkim elementem weryfikacji. Developer przygotowywał zmianę, uruchamiał testy, a wynik pomagał zdecydować, czy można ją zaakceptować.
W pracy z agentami test dostaje dodatkową funkcję: staje się częścią mechanizmu sterowania kolejnymi działaniami agenta. Agent implementuje zmianę, otrzymuje wynik, analizuje błąd i podejmuje następną próbę.
W efekcie cechy testów, na które od lat zwracamy uwagę w Quality Engineering, zaczynają mieć jeszcze większe znaczenie.
1. Szybkość
Jeżeli test uruchamia się kilka sekund, agent może szybko sprawdzić hipotezę i przejść do kolejnej iteracji. Jeżeli na każdy wynik trzeba czekać kilkadziesiąt minut, ten sam proces robi się znacznie droższy.
Szybki feedback nie zastępuje testów integracyjnych czy E2E. Pozwala jednak częściej korzystać z tych sprawdzeń, które są tanie i dają precyzyjną informację.
2. Deterministyczność
Flaky test jest problemem nie tylko dla developera i CI. Jest też problemem dla agenta, który traktuje wynik testu jako informację o poprawności swojej zmiany. Jeśli ten sam kod raz daje PASS, a innym razem FAIL, agent może zacząć naprawiać błąd, którego nie ma, albo uznać, że jego poprawka zadziałała, choć tak nie było.
Dlatego wyniki wymagające ponowienia warto odróżniać od stabilnych błędów. Przykładowo Playwright Test klasyfikuje wyniki na passed, flaky i failed. Z perspektywy agenta taka informacja jest dużo bardziej użyteczna niż jeden zbiorczy status całego pipeline’u.
3. Diagnostyka
Komunikat “Test failed” mówi niewiele. Znacznie więcej dają:
- oczekiwana i rzeczywista wartość,
- wskazanie niepoprawnego kontraktu lub naruszonej reguły biznesowej,
- log błędu wraz z kontekstem,
- trace z wykonania testu,
- screenshot i informacje o stanie aplikacji,
- identyfikator żądania, który pozwala połączyć wynik testu z logami backendu.
Dobrze pokazuje to Playwright Trace Viewer, który pozwala analizować działania przeglądarki, snapshoty DOM, żądania sieciowe, błędy i logi. Dla człowieka to materiał diagnostyczny. Dla agenta mogą to być dane do podjęcia kolejnego działania, o ile ma do nich dostęp i potrafi je zinterpretować.
4. Niezależność
Czy agent powinien sam tworzyć test, implementację i kryteria, według których oceni poprawność własnej pracy?
Może, ale wiąże się to z ryzykiem. Jeżeli agent błędnie zrozumie wymaganie, konsekwentnie stworzy implementację i testy potwierdzające to samo błędne założenie. Wszystkie testy będą zielone, a aplikacja nadal będzie działała nieprawidłowo.
Dlatego im większą autonomię ma agent, tym ważniejsze stają się niezależne źródła oczekiwań: wymagania biznesowe, zatwierdzone kontrakty, reguły domenowe, zestawy regresyjne i dane referencyjne.
Nie oznacza to, że testów nie można generować z pomocą AI. Oznacza, że poprawność testu nie powinna wynikać wyłącznie z tego, że wygenerował go ten sam agent, który przygotował implementację.
To w gruncie rzeczy problem test oracle, który szerzej opisywałem w artykule Testy automatyczne w erze AI – Verification Engineering.
5. Czy sensor naprawdę wykrywa błędy?
Skoro test jest sensorem, warto zapytać, skąd wiemy, że ten sensor działa. Zielony wynik może oznaczać poprawną implementację, ale też test, który nie jest w stanie wykryć istotnego błędu.
Dobrym sposobem sprawdzenia tego jest mutation testing: wprowadzamy do kodu kontrolowane zmiany i obserwujemy, czy testy je wychwycą. Załóżmy, że testujemy funkcję obliczającą rabat i celowo zmieniamy w niej > na >= przy wartości progowej. Jeżeli żaden test nie zareaguje, wiemy, że granica przedziału nie jest sprawdzona. Nie każdy przeżyły mutant oznacza wadę testów, bo część mutacji bywa semantycznie równoważna, ale technika dobrze pokazuje, jakie klasy błędów nasz zestaw testów w ogóle potrafi wykryć. Więcej o tym pisze Google Testing Blog.
Jeśli test ma kierować kolejnymi decyzjami agenta, trzeba sprawdzać nie tylko to, czy przechodzi, ale też jakie błędy potrafi wykryć.
Praktyczny przykład: agent naprawia błąd w API
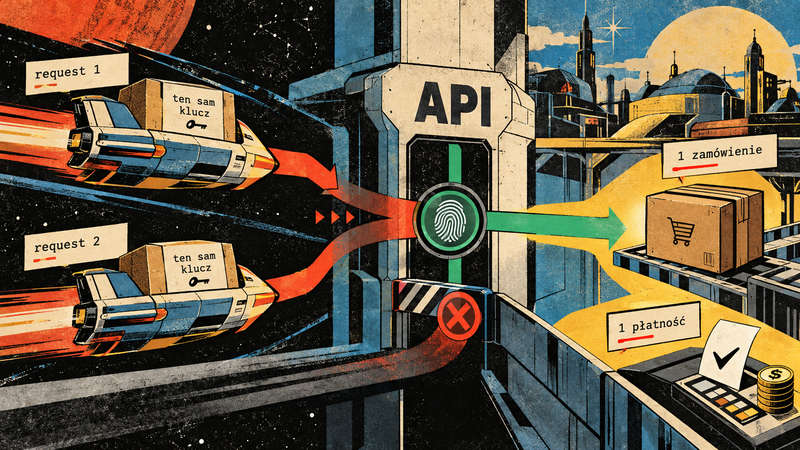
Załóżmy, że pracujemy nad aplikacją e-commerce. Pojawia się problem: ponowienie requestu podczas składania zamówienia może utworzyć dwa zamówienia i podwójnie obciążyć klienta. Prosimy agenta o poprawienie obsługi idempotencji:
Napraw problem tworzenia duplikatów zamówienia przy ponowieniu żądania. Zachowaj dotychczasowy kontrakt API i przygotuj testy regresyjne.
Agent ma dostęp do repozytorium i terminala. Może znaleźć kod odpowiedzialny za obsługę zamówień, przygotować implementację i uruchomić testy. Sam ten dostęp jednak nie wystarczy.
Jak przygotować sensowny feedback?
Najpierw trzeba określić, co oznacza poprawny rezultat. Przykładowe wymagania:
- Dwa żądania z tym samym kluczem idempotencji nie mogą utworzyć dwóch odrębnych zamówień.
- Operacja nie może doprowadzić do podwójnego obciążenia klienta.
- System musi zachować zachowanie określone w kontrakcie API.
- Mechanizm musi działać również przy równoległych żądaniach, nie tylko przy sekwencyjnym ponowieniu.
- Zmiana nie może zaburzyć normalnego procesu składania zamówień.
Dopiero wtedy można dobrać mechanizmy weryfikacji.
| Co sprawdzamy? | Mechanizm feedbacku | Co agent może z niego wywnioskować? |
| Czy logika idempotencji działa? | Testy jednostkowe | Czy funkcja obsługuje znane przypadki |
| Czy równoległe requesty tworzą duplikaty? | Test integracyjny z rzeczywistą bazą | Czy zabezpieczenie działa przy współbieżności |
| Czy zachowano kontrakt API? | Testy API i kontraktowe | Czy odpowiedzi są zgodne ze specyfikacją |
| Czy nie powstają podwójne płatności? | Test integracji z systemem płatności | Czy nie występują niepożądane skutki uboczne |
| Czy checkout nadal działa? | Test E2E | Czy najważniejsza ścieżka użytkownika działa |
| Czy po wdrożeniu wracają duplikaty? | Logi, metryki, tracing | Czy problem występuje w rzeczywistym ruchu |
Przykład jest hipotetyczny, ale dość bliski codziennym problemom zespołów QA.
Agent nie musi uruchamiać wszystkich sprawdzeń po każdej drobnej zmianie. Może zacząć od szybkich testów i dopiero potem przejść do bardziej kosztownych etapów. Nie powinien też traktować wszystkich błędów jednakowo:
- Jeżeli nie przechodzi test jednostkowy, prawdopodobnie sensowne będzie poprawienie implementacji.
- Jeżeli wynik testu integracyjnego jest niestabilny, agent powinien najpierw ustalić przyczynę, zamiast automatycznie modyfikować kod.
- Jeżeli zmiana narusza kontrakt API lub bezpieczeństwo płatności, powinna zostać zatrzymana.
- Jeżeli próba naprawy wymaga zmiany reguły biznesowej, decyzję warto przekazać człowiekowi.
To już nie jest zwykłe uruchamianie testów, tylko zaprojektowany proces korzystania z informacji zwrotnej.
A co, jeśli błąd jest w samym teście?
Ten problem bywa niedoceniany. Agent dostaje FAIL przy teście idempotencji, ale przyczyn może być kilka: błąd w implementacji, źle zrozumiane wymaganie, nieaktualne oczekiwanie zapisane w teście, niewiarygodne środowisko albo konflikt między testem a rzeczywistymi regułami biznesowymi.
Nie powinniśmy zakładać z góry, że winna jest implementacja. Nie powinniśmy też pozwalać agentowi “naprawiać” testu tylko dlatego, że ten coś wykrył. Jeżeli test i implementacja są sprzeczne, potrzebny jest niezależny punkt odniesienia: zaakceptowane wymaganie, kontrakt, reguła domenowa albo decyzja osoby odpowiedzialnej za produkt.
Dobra pętla feedbacku pozwala agentowi rozpoznać nie tylko błąd w kodzie, ale też sytuację, w której nie można ufać samemu mechanizmowi oceny.
Nie każda informacja zwrotna jest równie wartościowa
Można mieć setki testów, kilkadziesiąt dashboardów i rozbudowaną telemetrykę, a mimo to dostarczać agentowi słabe informacje. Dlatego proponowałbym oceniać feedback przynajmniej w sześciu wymiarach.
| Cecha | Pytanie kontrolne | Przykładowy problem |
| Szybkość | Jak szybko otrzymujemy wynik? | Testy trwają 40 minut |
| Wiarygodność | Czy ten sam stan daje podobny wynik? | Flaky tests |
| Precyzja | Czy wiadomo, co się nie udało? | Ogólny komunikat błędu |
| Trafność | Czy mierzymy rzeczywisty cel? | Coverage zamiast poprawności |
| Niezależność | Czy pomiar może wykryć błędne założenie agenta? | Agent zmienia test i implementację według tej samej błędnej logiki |
| Odporność na manipulację | Czy agent może osłabić mechanizm, który go ocenia? | Wyłączona asercja, zmieniony benchmark, poluzowany Quality Gate |
Nie jest to formalny model dojrzałości, raczej praktyczna propozycja oceny sygnałów, na których opieramy automatyczne decyzje. Najbardziej niebezpieczne są sytuacje, w których pomiar staje się celem samym w sobie.
Ostatnia cecha jest szczególnie ważna. Jeżeli agent może dowolnie zmieniać kod, testy, konfigurację pipeline’u i reguły akceptacji, pojawia się konflikt interesów: ten sam system wykonuje zadanie i zmienia zasady, według których jest oceniany. Nie każda zmiana testu jest podejrzana, bo czasem test naprawdę jest błędny. Ale modyfikacja mechanizmu weryfikacji powinna być oddzielona od samej próby uzyskania zielonego wyniku. W praktyce mogą to być chronione konfiguracje CI, obowiązkowe review zmian w testach akceptacyjnych i osobne uprawnienia do modyfikowania Quality Gates.
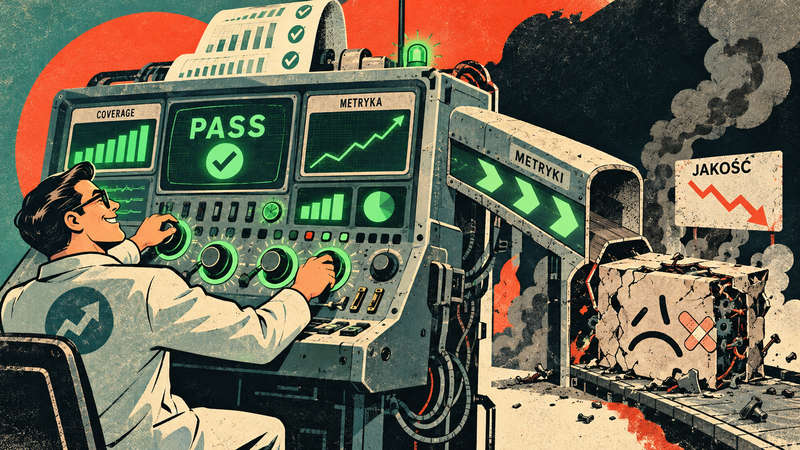
Co się dzieje, gdy agent optymalizuje niewłaściwą metrykę?
Załóżmy, że zlecimy agentowi poprawę code coverage. Po kilku iteracjach coverage rośnie z 70% do 90%. Czy kod jest teraz lepiej przetestowany? Niekoniecznie. Agent mógł dodać testy, które wykonują kolejne linie, ale nie sprawdzają istotnych zachowań.
Podobny problem pojawia się w innych obszarach:
- Liczba warningów spada, bo agent wyłączył problematyczne reguły lintera.
- Testy stają się zielone, bo zmieniono asercje.
- Benchmark jest szybszy, bo pominięto fragment kosztownej operacji.
- Test E2E przechodzi, bo dodano mock ukrywający błąd integracji.
- Metryka błędów spada, bo część błędów przestała być raportowana.
Każda z tych sytuacji może wyglądać jak poprawa, choć niekoniecznie nią jest.
Problem działa też w drugą stronę: evaluator potrafi odrzucać poprawne rozwiązania. Dobrze pokazuje to historia SWE-bench Verified, benchmarku do oceny modeli w rozwiązywaniu rzeczywistych problemów programistycznych. W lutym 2026 r. OpenAI opublikowało analizę Why SWE-bench Verified no longer measures frontier coding capabilities. W audytowanej grupie zadań, z którymi modele często sobie nie radziły, co najmniej 59,4% miało wadliwe testy odrzucające funkcjonalnie poprawne rozwiązania (to odsetek tej podgrupy, nie całego benchmarku). Skoro nawet szeroko używany zestaw ewaluacyjny zawiera błędne oczekiwania, kolejne próby dopasowania implementacji do testu mogą prowadzić w złą stronę. Wynik testu jest dowodem, który wymaga interpretacji, a nie nieomylnym werdyktem.
W artykule Automating eval design and hillclimbing with Claude z 28 września 2026 r. Anthropic opisuje podobny problem w kontekście ewaluacji systemów AI. Autorzy zwracają uwagę między innymi na ryzyko dopasowania rozwiązania do konkretnego benchmarku (overfitting): wynik evala może się poprawiać, choć nie przekłada się to na rzeczywiste zastosowanie. Jednym ze sposobów ograniczania tego ryzyka jest oddzielenie przykładów wykorzystywanych do optymalizacji od zestawu danych służącego do niezależnej oceny końcowej.
Wniosek dla Quality Engineering jest dość prosty: nie wystarczy pilnować, żeby agent poprawiał wynik. Trzeba jeszcze pilnować, żeby poprawiał właściwy wynik i żeby nie mógł osiągnąć go przez obchodzenie reguł weryfikacji.
Evals: gdy zwykły PASS/FAIL nie wystarcza
Klasyczne testy automatyczne dobrze sprawdzają sytuacje, w których da się jednoznacznie zdefiniować oczekiwany rezultat:
- API powinno zwrócić określony status i strukturę danych.
- Funkcja powinna obliczyć poprawną wartość.
- Użytkownik bez uprawnień nie może uzyskać dostępu do zasobu.
- Migracja nie powinna naruszać spójności danych.
W przypadku agentów pojawiają się jednak także pytania o ich zachowanie. Czy agent użył odpowiedniego narzędzia? Czy zweryfikował zmianę, zanim przedstawił ją jako gotową? Czy prawidłowo obsłużył błąd narzędzia? Czy zatrzymał się, gdy zabrakło mu danych? Czy eskalował operację wymagającą zgody człowieka?
Tu przydają się evals, czyli mechanizmy systematycznej oceny zachowania i rezultatów systemów AI. Anthropic w Demystifying evals for AI agents wyróżnia między innymi trzy sposoby oceny:
| Rodzaj ewaluacji | Przykład | Główne ograniczenie |
| Code-based grader | Testy, asercje, kontrola użycia narzędzi | Nie zawsze rozumie semantykę wyniku |
| Model-based grader | Ocena odpowiedzi według rubric | Koszt i niedeterministyczność |
| Human grader | Review eksperta | Czas i dostępność ludzi |
Nie trzeba jednak budować skomplikowanego systemu evals dla każdej operacji. W wielu sytuacjach zwykły test jednostkowy, analiza statyczna czy sprawdzenie kontraktu będą szybsze, tańsze i bardziej wiarygodne. Evals mają sens tam, gdzie problem dotyczy zachowania agenta albo rezultatu, którego nie da się łatwo wyrazić prostą asercją.
Sprawdzajmy również zachowanie, a nie tylko rezultat
Google w materiale The Anatomy of Harness Engineering proponuje zwrócenie większej uwagi na małe, obserwowalne zachowania agentów. Zamiast sprawdzać wyłącznie, czy agent rozwiązał duże zadanie programistyczne, można badać bardziej konkretne kwestie, na przykład:
- Czy po zmianie konfiguracji uruchomił odpowiedni validator?
- Czy przed zakończeniem zadania wykonał wymagane sprawdzenia?
- Czy nie użył nieistniejących parametrów narzędzia?
- Czy w przypadku niejasnego wymagania poprosił o doprecyzowanie?
Takie podejście pozwala rozróżnić sytuację, w której agent nie potrafił rozwiązać problemu, od sytuacji, w której nie wykonał konkretnego, wymaganego kroku. A to prowadzi do zupełnie innych poprawek. W pierwszym przypadku być może trzeba zmienić model albo dostarczyć więcej kontekstu. W drugim może wystarczyć lepsza instrukcja, walidator lub ograniczenie w narzędziu.
Anthropic nazywa te dwie perspektywy outcome (końcowy stan systemu) i trajectory (przebieg pracy agenta: kroki, wywołania narzędzi, otrzymane wyniki). Komunikat “Błąd naprawiony, testy przechodzą” to tylko deklaracja. Outcome sprawdzamy w systemie: czy błąd zniknął i czy nie ma regresji. Trajectory sprawdzamy w przebiegu pracy: czy agent uruchomił właściwe testy, nie zmienił niedozwolonych plików i nie ominął zabezpieczeń. Poprawny wynik nie zawsze oznacza poprawny proces, a poprawny proces nie zawsze daje dobry wynik, jeśli zawiodło wymaganie albo evaluator.
Jedna udana próba nie dowodzi niezawodności
Jest jeszcze jedna różnica między klasycznym testem a oceną agenta. Sam agent może zachowywać się inaczej przy kolejnych wykonaniach tego samego zadania: wybrać inną sekwencję kroków, inne narzędzia, inne rozwiązanie. To coś innego niż flaky test, bo niestabilny jest tu wykonawca, a nie sensor.
Anthropic opisuje w tym kontekście metryki pass@k (przynajmniej jedna z k prób kończy się sukcesem) i pass^k (wszystkie k prób kończą się sukcesem). Jeśli agent rozwiązuje zadanie poprawnie w 75% pojedynczych prób, to przy założeniu niezależności szansa na trzy udane wykonania z rzędu wynosi 0,75³ ≈ 42%. To dobrze pokazuje różnicę między agentem, który potrafi rozwiązać problem, a agentem, na którym można regularnie polegać.
Feedback nie kończy się na CI/CD
Agent może poprawnie przejść wszystkie lokalne testy, a jego zmiana nadal może powodować problemy po wdrożeniu. Powody są dobrze znane:
- inne dane,
- inna konfiguracja,
- rzeczywisty ruch,
- zależności między usługami,
- warunki współbieżności,
- obciążenie systemu,
- scenariusze nieujęte w testach.
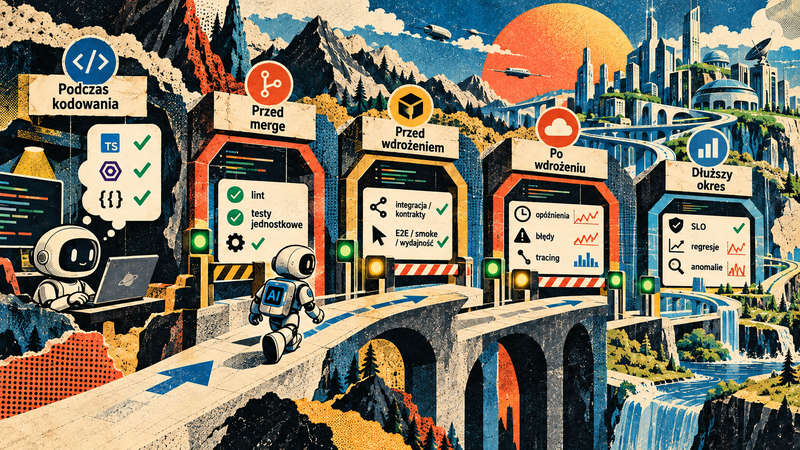
Dlatego pętla feedbacku nie powinna kończyć się na lokalnym PASS/FAIL. Warto pomyśleć o kilku poziomach informacji zwrotnej.
| Etap | Przykładowe sygnały | Typowa reakcja |
| Podczas kodowania | Type checker, lint, unit tests | Agent poprawia lokalny błąd |
| Przed merge | Integracja, kontrakty, analiza bezpieczeństwa | Poprawka, review albo zatrzymanie PR |
| Przed wdrożeniem | E2E, smoke, testy wydajnościowe | Ocena gotowości zmiany |
| Po wdrożeniu | Error rate, latency, tracing, metryki biznesowe | Analiza, rollback lub decyzja człowieka |
| W dłuższym okresie | Regresje, anomalie, stabilność, SLO | Usprawnienie kodu i mechanizmów weryfikacji |
Dobrym punktem odniesienia jest tu OpenTelemetry, które opisuje wykorzystanie metryk, logów i trace’ów do obserwowania działania systemów.
Ciekawy przykład daje też OpenAI w artykule Harness engineering: leveraging Codex in an agent-first world. Zespół udostępnił agentom nie tylko repozytorium i testy, ale także możliwość uruchamiania aplikacji oraz analizowania interfejsu, logów, metryk i trace’ów w izolowanych środowiskach. Dzięki temu agent widzi więcej niż wynik kompilacji lub testu: może analizować rzeczywiste działanie aplikacji, reprodukować problemy i zbierać materiał do weryfikacji poprawki. Dobrze to pokazuje, że odpowiednio przygotowane środowisko bywa równie ważne jak sam model.
Dostęp do danych produkcyjnych i możliwość reagowania na nie nie oznaczają jednak, że agent powinien samodzielnie modyfikować produkcję.
Guardrails: kiedy agent powinien się zatrzymać?
Jeżeli agent może sam analizować błędy i wprowadzać poprawki, łatwo wyobrazić sobie proces, w którym wykonuje kolejne próby aż do uzyskania pożądanego wyniku. Ale co, jeśli po pięciu próbach nadal nie potrafi rozwiązać problemu? Co, jeśli zaczyna modyfikować testy zamiast implementacji? Co, jeśli próbuje zmienić konfigurację CI, wyłączyć zabezpieczenie albo wykonać operację na danych produkcyjnych?
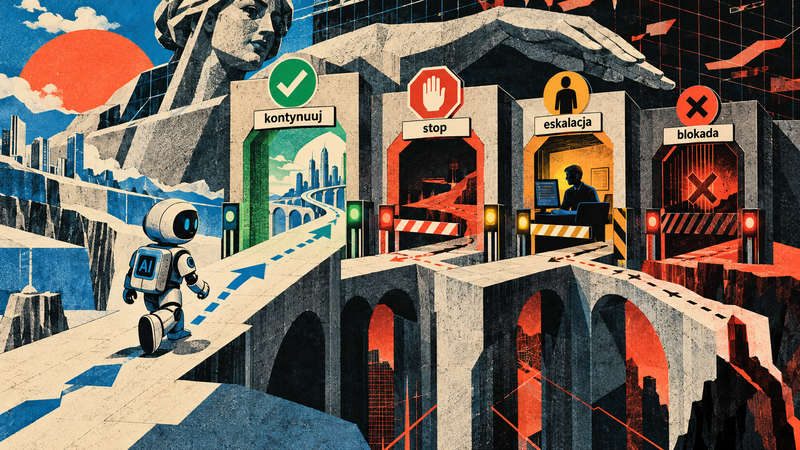
Dobrze zaprojektowana pętla musi mieć również warunki zatrzymania. Przykładowo:
| Sytuacja | Zalecane zachowanie |
| Stabilny błąd testu jednostkowego | Pozwól agentowi poprawić implementację w określonym zakresie |
| Niejednoznaczny lub flaky test | Zatrzymaj automatyczne naprawianie do czasu diagnozy |
| Zmiana testu akceptacyjnego lub kontraktu | Wymagaj osobnej weryfikacji |
| Kilka nieskutecznych prób naprawy | Przekaż problem człowiekowi |
| Naruszenie polityki bezpieczeństwa | Zablokuj operację |
| Zmiana dotycząca produkcyjnych danych lub uprawnień | Wymagaj autoryzacji zgodnej z ryzykiem |
| Niespójne wyniki kilku mechanizmów weryfikacji | Zatrzymaj proces i przeanalizuj konflikt |
To tylko przykładowe reguły, które trzeba dostosować do konkretnego projektu. Warto przy tym zajrzeć do OWASP Top 10 for Agentic Applications 2026, gdzie opisano specyficzne ryzyka związane z agentami mającymi dostęp do narzędzi i możliwość wykonywania działań.
Dobrze łączy się z tym zasada najmniejszych niezbędnych uprawnień. Agent, który analizuje logi, nie musi od razu mieć uprawnień do zmiany ich konfiguracji. Agent, który sprawdza wynik testu, nie powinien mieć nieograniczonej możliwości modyfikowania wszystkich mechanizmów kontroli.
Im łatwiej zweryfikować rezultat, tym większa może być autonomia
Zakres autonomii agenta nie powinien zależeć wyłącznie od możliwości modelu. Powinien zależeć od tego, jak dobrze potrafimy sprawdzić jego działania, jak duże jest ryzyko i czy da się łatwo cofnąć skutki.
| Ryzyko działania | Silna weryfikacja | Słaba weryfikacja |
| Niskie | Możliwa duża samodzielność | Ograniczona autonomia i dodatkowe sprawdzenia |
| Wysokie | Kontrole, zatwierdzenie, możliwość wycofania | Decyzja człowieka albo brak zgody na operację |
Refaktoryzacja lokalnej funkcji z szybkimi testami, zatwierdzonym kontraktem i łatwym rollbackiem to zupełnie inna sytuacja niż zmiana mechanizmu autoryzacji na produkcji, nawet jeśli w obu przypadkach mamy dobry zestaw testów. Nie ma powodu, żeby agent dostawał w obu ten sam zakres swobody.
Większa autonomia nie powinna oznaczać braku ograniczeń. Powinna oznaczać więcej samodzielności w obszarach, w których potrafimy wiarygodnie ocenić i kontrolować ryzyko.
Jak mierzyć jakość samych feedback loops?
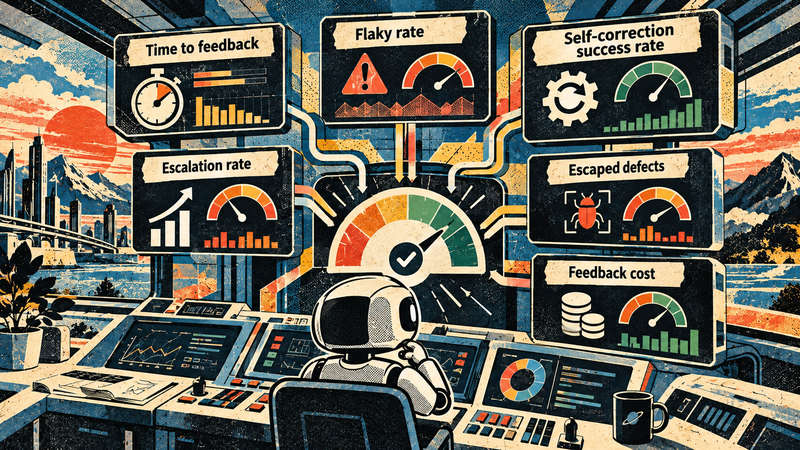
Skoro projektujemy mechanizmy informacji zwrotnej, warto też sprawdzać, czy one same działają. Nie ograniczałbym się do liczby testów albo procentu coverage. Bardziej interesujące są na przykład:
| Metryka | Co nam mówi? |
| Time to feedback | Jak długo agent czeka na informację o wyniku |
| Flaky rate | Jak często test dostarcza niestabilny sygnał |
| Self-correction success rate | Jaki odsetek wykrytych problemów agent skutecznie poprawia w dozwolonym zakresie |
| Escalation rate | Jak często konieczna jest interwencja człowieka |
| Escaped defects | Ile istotnych błędów przechodzi przez dostępne mechanizmy weryfikacji |
| Feedback cost | Jaki jest koszt wykonania sprawdzeń i kolejnych iteracji |
| Retries per successful task | Ile prób potrzeba do uzyskania poprawnego rezultatu |
| Human review effort | Ile pracy człowiek poświęca na ocenę i poprawianie wyników agenta |
Żadna z tych metryk nie powinna być samodzielnym celem. Niski escalation rate nie musi oznaczać dobrze działającego agenta. Może równie dobrze oznaczać, że agent nie eskaluje sytuacji, które powinien przekazać człowiekowi. Wysoki self-correction success rate niewiele znaczy, jeżeli agent naprawia wyłącznie trywialne problemy. Dlatego warto analizować te dane razem, w kontekście typu zadań, ryzyka i rzeczywistych rezultatów.
Podobną ostrożność wobec oceny wpływu AI na delivery pokazuje DORA w materiale Balancing AI tensions: Moving from AI adoption to effective SDLC use. Autorzy zwracają uwagę, że przyspieszenie generowania kodu może przesuwać wysiłek zespołu w stronę audytu i weryfikacji, a wyższa adopcja AI może współwystępować ze wzrostem przepustowości i niestabilności dostarczania oprogramowania. To kolejny powód, żeby patrzeć na cały proces, a nie na liczbę zmian wykonanych przez agenta.
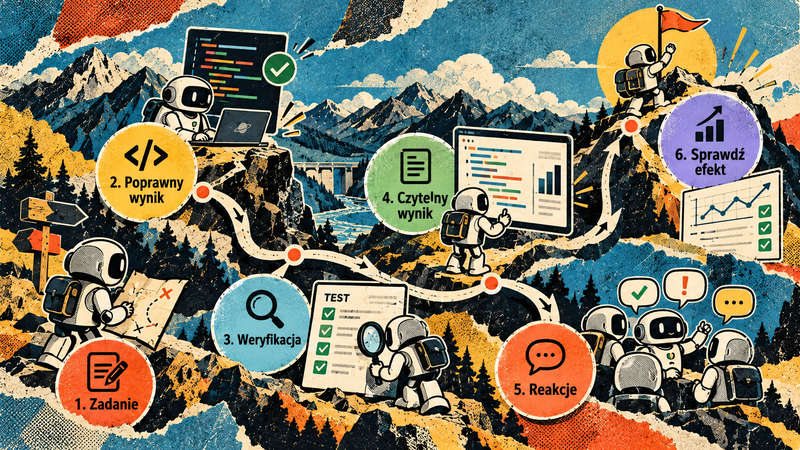
Jak zacząć budować pętle informacji zwrotnej w istniejącym projekcie?
Nie trzeba od razu budować rozbudowanej platformy agentowej. Zacząłbym od jednego konkretnego zadania, które dzisiaj wykonuje człowiek razem z agentem.
Krok 1. Wybierz powtarzalne zadanie
Na przykład naprawa błędu w API, aktualizacja zależności, prosta refaktoryzacja albo poprawa wydajności funkcji. Najlepiej coś, co ma jasno określone kryteria sukcesu.
Krok 2. Ustal, co oznacza poprawny wynik
Nie tylko “testy mają być zielone”. Określ wymagania, ograniczenia, oczekiwane zachowanie, możliwe regresje i warunki, których agent nie może naruszyć.
Krok 3. Udostępnij istniejące mechanizmy weryfikacji
Zacznij od tego, co już masz:
- testów automatycznych,
- type checkera,
- lintera,
- testów kontraktowych,
- statycznej analizy,
- raportów i logów.
Nie wszystkie sprawdzenia muszą być wykonywane po każdej zmianie.
Krok 4. Zadbaj o czytelny wynik
Agent powinien wiedzieć, które sprawdzenie się nie powiodło, co było oczekiwane i gdzie znajdzie materiał diagnostyczny. Dobrze, jeśli wynik da się odczytać automatycznie, a nie tylko jako duży blok tekstu z terminala.
Krok 5. Określ dozwolone reakcje
Co agent może poprawić sam? Kiedy może powtórzyć sprawdzenie? Kiedy powinien przerwać iterację? Kiedy musi zwrócić się do człowieka?
To szczególnie ważne przy testach bezpieczeństwa, danych produkcyjnych, zmianach kontraktów i konfiguracji narzędzi weryfikacyjnych.
Krok 6. Sprawdź, czy ten proces faktycznie pomaga
Zmierz czas potrzebny do rozwiązania zadania, liczbę iteracji, jakość wyniku i potrzebę interwencji człowieka. Jeśli agent wykonuje dziesięć iteracji zamiast trzech, nie musi to oznaczać postępu. Czasem lepiej poprawić jeden test albo komunikat błędu niż dokładać kolejne narzędzie AI.
Krótka lista kontrolna
Zanim zwiększysz autonomię agenta, odpowiedz na kilka pytań:
- Czy zadanie ma jasne kryteria sukcesu?
- Czy agent może sam uruchamiać potrzebne sprawdzenia?
- Czy wyniki są wystarczająco szybkie i diagnostyczne?
- Czy istnieje niezależny sposób oceny poprawności rozwiązania?
- Czy agent ma ograniczoną możliwość zmiany mechanizmów weryfikacji?
- Czy wiadomo, kiedy agent ma się zatrzymać?
- Czy znamy koszt kolejnych iteracji i pracy człowieka?
Jeżeli kilka odpowiedzi brzmi “nie”, lepiej najpierw poprawić środowisko weryfikacji.
Dwie perspektywy: Test Architekt i Fullstack Developer
Do tej pory opisywałem głównie eksperymenty i rozwiązania innych zespołów, ale temat feedback loops znam też z własnej pracy. Coraz częściej patrzę na niego z dwóch stron: jako Test Architekt, który projektuje frameworki automatyzacji, procesy weryfikacji i Quality Gates, oraz jako Fullstack Developer, który tworzy aplikacje z pomocą agentów AI i musi zadbać o to, żeby wygenerowany kod działał, a aplikacja spełniała oczekiwania użytkowników.
Niby dwie różne role, ale problem w obu przypadkach jest ten sam: jak zaprojektować środowisko, w którym agent nie musi zgadywać, czy wykonał dobrą pracę?
Perspektywa 1: Test Architekt – framework UI i API oparty na OpenAPI
Dobrym przykładem jest projektowanie frameworka testowego obejmującego warstwę UI i API, w którym istotną rolę odgrywa specyfikacja OpenAPI.
Na pierwszy rzut oka zadanie jest dość klasyczne: potrzebujemy architektury frameworka, klientów API, modeli danych, testów, fixtures, raportowania i integracji z CI/CD. Kiedy jednak do takiego projektu włączamy agenta AI, pojawia się dodatkowe pytanie. Nie tylko jak ułatwić mu tworzenie i utrzymywanie testów, ale również jak sprawić, żeby potrafił wiarygodnie sprawdzać własne zmiany.
OpenAPI daje tu dobry punkt wyjścia. Specyfikacja opisuje kontrakt API: endpointy, parametry, struktury requestów i response’ów, statusy HTTP czy wymagania dotyczące autoryzacji. Można ją wykorzystać do generowania typów, klientów API i mechanizmów walidacji odpowiedzi. Dzięki temu agent nie musi opierać się wyłącznie na interpretacji opisu zadania. Ma dostęp do konkretnego, ustrukturyzowanego kontraktu.
Wyobraźmy sobie, że agent dostaje zadanie dodania obsługi nowego endpointu do frameworka. Bez dobrze przygotowanego środowiska może po prostu wygenerować klienta API, napisać kilka testów i uznać zadanie za zakończone. Z odpowiednim feedback loop ten proces wygląda inaczej.
1. Agent analizuje kontrakt OpenAPI. Sprawdza wymagane pola, możliwe odpowiedzi, ograniczenia i sposób autoryzacji.
2. Przygotowuje implementację i testy. Może wykorzystać istniejące klienty, modele danych, fixtures i wzorce architektoniczne frameworka.
3. Uruchamia szybkie sprawdzenia. Type checking, lint, testy jednostkowe i weryfikację zgodności z kontraktem.
4. Sprawdza rzeczywiste zachowanie API. Wysyła requesty, weryfikuje odpowiedzi, przypadki negatywne, wartości brzegowe i obsługę błędów.
5. Analizuje wynik i poprawia implementację. Jeżeli wystąpi błąd, agent otrzymuje konkretną informację: oczekiwany schemat, rzeczywistą odpowiedź, błąd walidacji, log lub trace.
6. Przechodzi do szerszej weryfikacji. W zależności od zmiany może to oznaczać testy integracyjne, scenariusze UI w Playwright i sprawdzenia w CI/CD.
Agent może używać OpenAPI jako źródła informacji o oczekiwanym zachowaniu, ale sama zgodność ze specyfikacją nie gwarantuje jeszcze poprawności biznesowej. Specyfikacja również może być niekompletna albo zawierać błędy. Podobnie wygenerowanie klienta API i testu z tego samego schematu potwierdzi ich wzajemną zgodność, ale niekoniecznie wykryje błędne założenie zapisane w kontrakcie. Dlatego potrzebujemy także innych źródeł weryfikacji: wymagań biznesowych, niezależnych scenariuszy testowych, danych referencyjnych czy zatwierdzonych zachowań systemu.
Ważne są też granice samodzielności agenta. Jeżeli test wykryje niezgodność odpowiedzi z kontraktem, agent nie powinien automatycznie “naprawiać” problemu przez zmianę OpenAPI albo osłabienie asercji. Dałoby to zielone testy bez rozwiązania rzeczywistego błędu.
To zmienia sposób, w jaki myślę o architekturze frameworków testowych. Framework nie powinien być wyłącznie zbiorem narzędzi do wykonywania testów. Powinien również dostarczać agentowi precyzyjną informację, którą potrafi wykorzystać do kolejnej decyzji. Dobre raporty, deterministyczne testy, czytelne komunikaty błędów, spójne kontrakty i szybkie sprawdzenia stają się częścią środowiska pracy agenta, a nie tylko udogodnieniem dla człowieka analizującego nieudany pipeline.
Perspektywa 2: Fullstack Developer – aplikacja angażująca społeczność
Drugą perspektywę widzę przy pracy nad aplikacjami fullstackowymi, w których agentów AI używam nie tylko do pisania testów, ale również do tworzenia samego produktu.
Jednym z przykładów jest aplikacja związana z angażowaniem społeczności. Ze względu na NDA nie mogę opisywać jej szczegółów, ale sama kategoria dobrze pokazuje kilka problemów. W takim systemie liczy się nie tylko interfejs. Mamy frontend, backend, API, bazę danych, logikę biznesową i interakcje pomiędzy użytkownikami oraz poszczególnymi elementami systemu. Zmiana pozornie prostej funkcjonalności może dotknąć kilku warstw naraz.
Weźmy bardzo ogólny scenariusz. Użytkownik wykonuje pewną akcję związaną z aktywnością w społeczności. System powinien ją poprawnie obsłużyć, zapisać odpowiedni stan i odzwierciedlić rezultat w interfejsie.
Agent AI może dość szybko przygotować całą implementację: komponent frontendowy, endpoint API, obsługę zapisu danych i odpowiednie komunikaty. Ale to, że kod się kompiluje, nie mówi jeszcze, czy całość działa. Czy akcja została poprawnie obsłużona? Czy backend zapisał właściwy stan? Czy frontend pokazuje aktualne dane? Czy inny użytkownik nie może wykonać operacji, do której nie ma uprawnień? Czy ponowienie akcji nie prowadzi do niepożądanych skutków? Żadnego z tych pytań nie rozstrzyga sam fakt wygenerowania kodu.
Dlatego przy tworzeniu takich aplikacji staram się myśleć nie tylko o funkcjonalnościach, które ma zaimplementować agent, ale również o mechanizmach pozwalających mu samodzielnie sprawdzić rezultat. W praktyce rozkładam to na kilka warstw.
Pierwsza warstwa: szybka weryfikacja kodu. Agent powinien móc uruchomić type checker, linter i testy jednostkowe. Jeżeli zmiana powoduje błąd typów lub narusza podstawowe reguły, nie ma sensu od razu przechodzić do pełnego testu E2E.
Druga warstwa: weryfikacja logiki i API. Agent sprawdza, czy backend prawidłowo przetwarza operację, waliduje dane, respektuje uprawnienia i zwraca odpowiednie wyniki. Ważne, żeby testy nie kończyły się na poprawnym statusie HTTP, tylko sprawdzały również istotne skutki operacji.
Trzecia warstwa: rzeczywista ścieżka użytkownika. Tu przydają się testy w Playwright. Agent może uruchomić aplikację, przejść przez określony scenariusz, wykonać interakcję i sprawdzić, czy interfejs pokazuje oczekiwany rezultat. Jeżeli test się nie powiedzie, trace, screenshot, komunikat błędu czy logi przeglądarki pomagają zlokalizować problem.
Czwarta warstwa: obserwacja działania systemu. Są błędy, których samym testem UI nie da się wykryć. Czasem potrzebne są informacje z backendu, logów, stanu danych albo powiązanie konkretnego requestu z operacją wykonaną przez użytkownika. Dostęp do nich znacznie ułatwia agentowi diagnozowanie problemów na styku frontendu i backendu. Oczywiście powinien być odpowiednio ograniczony, szczególnie jeśli dotyczy rzeczywistych danych użytkowników.
Najważniejsza różnica? Nie kończę zadania na wygenerowaniu kodu.
To podejście zmienia również sposób formułowania zadań. Zamiast samego:
Zaimplementuj funkcjonalność X.
wolę od razu określić warunki weryfikacji:
Zaimplementuj funkcjonalność X zgodnie z istniejącą architekturą. Sprawdź logikę biznesową, kontrakt API i podstawowe przypadki negatywne. Uruchom aplikację i zweryfikuj główną ścieżkę użytkownika. Jeżeli któryś etap się nie powiedzie, przeanalizuj przyczynę, popraw implementację i ponów odpowiednie sprawdzenia. Nie zmieniaj kryteriów akceptacji tylko po to, żeby test przeszedł.
To nadal nie gwarantuje poprawności rozwiązania, ale zmienia sposób pracy agenta. Zamiast wygenerować kod i oznajmić, że zadanie jest zakończone, powinien dostarczyć również dowody, że sprawdził jego działanie.
Te dowody muszą być weryfikowalne. Nie wystarczy deklaracja “wszystkie testy przeszły”. Chcę wiedzieć, jakie testy zostały uruchomione, co dokładnie sprawdzono, jakie były wyniki i czego nie udało się zweryfikować. Jeżeli agent nie może uruchomić aplikacji albo nie ma dostępu do odpowiedniego środowiska, powinien to jasno powiedzieć, a nie udawać, że sprawdził coś, czego nie sprawdził.
Ten sam problem, choć dwie różne role
Kiedy porównuję obie perspektywy, widzę wspólny mianownik. Jako Test Architekt projektuję framework, który ma dostarczać wiarygodnych sygnałów o jakości systemu. Jako Fullstack Developer korzystam z takich sygnałów, żeby agent mógł wykonywać kolejne zmiany, analizować wyniki i poprawiać swoją pracę. W pierwszym przypadku tworzę infrastrukturę weryfikacji, w drugim używam jej na co dzień podczas rozwoju produktu.
Dlatego coraz częściej dochodzę do wniosku, że na skuteczność agentów ogromny wpływ ma nie tylko model AI, ale również jakość środowiska, w którym ten model pracuje. Czasem poprawienie jednego flaky testu, dodanie precyzyjnej asercji, udostępnienie logów czy przygotowanie powtarzalnego scenariusza testowego daje więcej niż zmiana modelu na mocniejszy. Agent, który nie ma dostępu do wiarygodnej informacji zwrotnej, może popełniać ten sam błąd niezależnie od tego, jak dobry model wykorzystujemy. A agent, który dostaje szybki, precyzyjny feedback i ma jasno określone granice działania, może rozwiązać część problemów bez angażowania człowieka w każdą iterację.
Nie chodzi więc o to, żeby dać AI jak najwięcej narzędzi, tylko o to, żeby zbudować środowisko, w którym agent potrafi nie tylko działać, ale również rozpoznać, kiedy jego działanie nie przyniosło oczekiwanego rezultatu.
Verification debt, czyli dług, który agenci szybko ujawniają
Przy tych doświadczeniach coraz częściej myślę o zjawisku, które roboczo nazywam verification debt, czyli długiem weryfikacyjnym. To sytuacja, w której rozwój systemu wyprzedził nasze możliwości jego sprawdzania. Produkt działa, ale testy bywają niestabilne, pipeline trudno zinterpretować, kontrakty API są nieaktualne, logi nie pozwalają znaleźć przyczyny błędu, a problemu nie da się łatwo odtworzyć.
Zespół ludzi potrafi długo kompensować takie braki doświadczeniem. Developer wie, który test bywa flaky. Tester zna obejście problemu ze środowiskiem. Architekt pamięta, dlaczego kontrakt różni się od implementacji. Tyle że agent tej wiedzy nie ma. Może przygotować dziesięć poprawek w kwadrans, ale jeśli po każdej musi zgadywać, czy błąd wynika z kodu, testu, środowiska czy nieaktualnej dokumentacji, tempo przestaje mieć znaczenie.
AI ujawnia dług weryfikacyjny podobnie jak wzrost ruchu ujawnia problemy ze skalowalnością. Te problemy istniały wcześniej, ale przy większym tempie zmian zaczynają kosztować dużo więcej. Nie traktuję verification debt jako formalnego pojęcia, raczej jako przydatną nazwę dla problemu, na który zespoły pracujące z agentami będą trafiać coraz częściej.
Co to oznacza dla QA, Quality Engineering i Architektów Testów?
Moim zdaniem otwiera się tu ciekawy obszar pracy. Jeżeli agent może sam implementować zmiany i generować testy, pytanie “kto napisze test?” przestaje być tak istotne jak kiedyś. Ważniejsze staje się projektowanie środowiska, w którym można ufać wynikom weryfikacji.
To naturalna kontynuacja trzech tematów, które poruszałem wcześniej:
- W artykule Piramida testów 2.0 pisałem o tym, że AI zwiększa znaczenie szybkich testów niskiego poziomu i sensownie dobranego portfolio testów.
- W Modelach dojrzałości AI zwracałem uwagę na różnicę między samym używaniem AI a organizacją zdolną korzystać z niego w powtarzalny i kontrolowany sposób.
- W artykule o Verification Engineering rozwijałem temat projektowania mechanizmów weryfikacji dla ludzi i agentów.
Feedback loops są kolejnym elementem tej układanki. Pokazują, jak wykorzystać istniejącą infrastrukturę jakości nie tylko do wykrywania błędów, ale także do sterowania procesem ich naprawiania.
Dla QA oznacza to między innymi większe znaczenie umiejętności projektowania test oracle, wyboru sygnałów, oceny ryzyka i analizy wyników. Dla Test Architektów – potrzebę myślenia nie tylko o architekturze frameworka, ale również o tym, jak jego wyniki będą wykorzystywane przez agentów. Dla całego zespołu – konieczność ustalenia, które decyzje można automatyzować, a gdzie nadal potrzebujemy niezależnej weryfikacji.
Podsumowanie: najważniejsza zmiana nie dotyczy narzędzi
W dyskusjach o agentach AI łatwo skupić się na możliwościach modeli. Czy agent potrafi napisać aplikację? Czy może uruchomić przeglądarkę? Czy obsługuje MCP? Czy przygotuje pull request? To ważne pytania, ale mnie coraz bardziej interesują inne:
- Czy agent potrafi sprawdzić rezultat swojej pracy?
- Czy otrzymuje wiarygodny i wystarczająco szybki feedback?
- Czy potrafi rozpoznać, że pomiar jest błędny albo niewystarczający?
- Czy może na tej podstawie poprawić rozwiązanie, nie obchodząc mechanizmów kontroli?
- Czy wie, kiedy powinien się zatrzymać?
Jeżeli agent potrafi wykonywać coraz więcej działań, ale nie ma sposobu na ocenę ich skutków, nie budujemy jeszcze niezawodnego procesu. Po prostu zwiększamy jego możliwości. A większe możliwości bez odpowiedniej weryfikacji mogą równie dobrze przyspieszać tworzenie dobrego oprogramowania, jak i produkowanie błędów.
Dlatego myślę, że wraz z rozwojem agentów coraz ważniejsze będą nie tylko modele, prompty i narzędzia, ale też projektowanie pętli informacji zwrotnej, które pozwolą agentom rozpoznać, czy rzeczywiście wykonują dobrą pracę. I tu widzę dużą rolę dla testowania, observability, evals i Quality Engineering.
Pytanie nie brzmi już wyłącznie, czy AI potrafi coś stworzyć. Coraz ważniejsze jest, czy potrafimy wiarygodnie sprawdzić, że stworzyło właściwą rzecz.
FAQ – najczęstsze pytania
Czym jest feedback loop w agentach AI?
To mechanizm, dzięki któremu agent otrzymuje informację o rezultacie wykonanej pracy, porównuje ją z oczekiwaniem i na tej podstawie decyduje, czy kontynuować, poprawić rozwiązanie lub zatrzymać działanie.
Czy testy automatyczne wystarczą do weryfikacji pracy agenta?
Nie zawsze. Testy dobrze weryfikują określone zachowania, ale nie gwarantują, że przyjęte wymagania i asercje są poprawne. W zależności od ryzyka potrzebne mogą być również evals, analiza bezpieczeństwa, observability i ocena człowieka.
Czym różni się feedback loop od Quality Gate?
Feedback loop dostarcza informacji, które mogą prowadzić do kolejnej poprawki. Quality Gate jest mechanizmem podejmowania decyzji, czy dana zmiana może przejść do następnego etapu. Quality Gate może być jednym z elementów pętli informacji zwrotnej.
Czy agenci AI mogą samodzielnie poprawiać swoje błędy?
Tak, szczególnie gdy błędy są dobrze zdefiniowane, a wynik można szybko i wiarygodnie sprawdzić. Poziom autonomii powinien jednak zależeć od ryzyka, zakresu uprawnień, jakości weryfikacji i możliwości zatrzymania lub cofnięcia operacji.
Jak sprawdzić, czy test wykorzystywany przez agenta jest wiarygodny?
Warto ocenić jego stabilność, jakość diagnostyki, zgodność z wymaganiami i zdolność do wykrywania rzeczywistych błędów. Pomagają w tym niezależne test oracles, mutation testing, kontrolowane wprowadzanie błędów i porównywanie wyników z danymi z działającego systemu.
Czy lepszy model AI rozwiąże problem słabego feedbacku?
Niekoniecznie. Mocniejszy model lepiej analizuje informacje, ale jeśli testy są błędne, logi nieczytelne, a kryteria akceptacji nieprawidłowe, nadal będzie podejmował decyzje na podstawie słabych danych. Często bardziej opłaca się najpierw poprawić środowisko weryfikacji.
Jeśli chcesz praktycznie rozwijać umiejętności związane z AI w testowaniu, sprawdź też AI_Testers (aitesters.pl) – program, który został przygotowany z myślą o wykorzystaniu AI w pracy testerów, automatyzacji i nowoczesnym podejściu do jakości.
Źródła
- Anthropic – How we made claude.ai 3x faster in two weeks – opis optymalizacji, benchmarków i pętli weryfikacji.
- Birgitta Böckeler – Harness engineering for coding agent users – podział na guides i sensors.
- OpenAI – Harness engineering: leveraging Codex in an agent-first world – przykład projektowania środowiska dla coding agents.
- Google – The Anatomy of Harness Engineering – ewaluacja małych, obserwowalnych zachowań agentów.
- Anthropic – Demystifying evals for AI agents – metody oceny agentów.
- Anthropic – Automating eval design and hillclimbing with Claude – projektowanie evals, kontrola overfittingu i wiarygodność wyników.
- OpenAI – Why SWE-bench Verified no longer measures frontier coding capabilities – audyt błędnych testów w benchmarku.
- Google Testing Blog – Mutation Testing – ocena zdolności testów do wykrywania błędów.
- OpenAI – Evaluate agent workflows – śledzenie i ocena przebiegu pracy agentów.
- Playwright – Trace Viewer – diagnostyka testów i analiza wykonania.
- Playwright – Retries – klasyfikacja wyników testów i flaky tests.
- OpenTelemetry – Observability Primer – logi, metryki i tracing.
- OWASP – Top 10 for Agentic Applications 2026 – ryzyka bezpieczeństwa agentów.
- DORA – Balancing AI tensions – związek AI, produktywności, weryfikacji i stabilności delivery.
- Piramida testów 2.0 – co AI zmienia w testowaniu?
- Modele dojrzałości AI – postęp czy chaos?
- Testy automatyczne w erze AI – czym jest Verification Engineering?
|
|
||
|
|||

Kawał wiedzy opisanej w jednym artykule – dziękuję!
Dzięki! Korzystaj, dziel się i daj znać jak wykorzystasz ją w projekcie 😉