
AI w dostępności cyfrowej: niebezpieczny audytor czy genialny asystent?
Dostępność cyfrowa to już nie tylko najlepsza praktyka – to podstawowe prawo człowieka i prawna konieczność. W miarę jak aplikacje internetowe stają się coraz bardziej złożone, polegając na dynamicznych komponentach i architekturze single-page, utrzymanie inkluzywnego środowiska cyfrowego musi odpowiednio się skalować. Zastosowanie sztucznej inteligencji (AI) i dużych modeli językowych (LLM) w audytach dostępności wywołało ogromną debatę: czy AI to niebezpieczny audytor podatny na halucynacje, czy genialny asystent, który pomaga programistom tworzyć lepsze rozwiązania?
Ten przewodnik, stanowiący uzupełnienie prezentacji “AI w dostępności: Niebezpieczny audytor czy genialny asystent?”, analizuje rolę AI w cyfrowej dostępności, obala mity, podkreśla przełomowe rozwiązania i przedstawia bezpieczny, skoncentrowany na człowieku model procesu.
Iluzja “zielonego paska”
Tradycyjne zautomatyzowane narzędzia skanujące (takie jak axe-core, WAVE i Lighthouse) wychwytują jedynie około 20% do 30% błędów związanych z dostępnością. Jednak kiedy firma Deque Systems opublikowała w 2021 roku raport stwierdzający, że automatyzacja objęła 57,38% problemów, wywołało to duże zamieszanie.
Skąd bierze się ta różnica? Wszystko sprowadza się do metodologii:
- Perspektywa unikalnych kryteriów WCAG (20-40%)
Kontrolowane badanie przeprowadzone przez brytyjski Government Digital Service (GDS Study 2017) przetestowało skanery na zestawie 142 znanych barier dostępności. Skanery poprawnie zidentyfikowały zaledwie 20% – 40% unikalnych problemów. W rzeczywistości tradycyjna automatyzacja obejmuje tylko 25% kryteriów sukcesu WCAG na poziomie A i 17% na poziomie AA. - Perspektywa objętości kodu (57,38%)
Firma Deque Systems (2021) oceniła ponad 13 000 stron i prawie 300 000 pojedynczych incydentów. Wartość 57,38% odzwierciedla skalę powtarzających się błędów w kodzie. Na przykład, jeśli w szablonie produktu brakuje etykiety formularza i błąd ten jest powielony na liście 1000 produktów, skaner zgłasza 1000 błędów. Naprawienie szablonu rozwiązuje wszystkie 1000 incydentów za jednym razem.
Pokazanie kierownictwu raportu twierdzącego, że “naprawiono 60% błędów” zazwyczaj oznacza, że pomyślnie usunięto szum składniowy w kodzie. Tymczasem 70% do 80% unikalnych, funkcjonalnych barier wciąż aktywnie blokuje użytkowników z niepełnosprawnościami.
Ślepe punkty tradycyjnych skanerów (ślepota semantyczna)
Narzędzia oparte na regułach analizują statyczny obiektowy model dokumentu (DOM) pod kątem obecności atrybutów, a nie ich znaczenia semantycznego. Mogą zweryfikować, że istnieje alt="image.jpg", ale nie potrafią stwierdzić, czy tekst sensownie opisuje obraz. Szukają tabindex="0", ale są całkowicie ślepe na to, czy logiczna kolejność fokusa ma sens dla człowieka nawigującego za pomocą klawiatury. Ignorują również dostępność poznawczą (COGA) oraz dynamiczne zmiany kontekstu.
Wystarczy wejść na strony takie jak UserInyerface.com – witrynę celowo zaprojektowaną jako koszmar pod względem doświadczeń użytkownika. Standardowy zautomatyzowany skaner mógłby dać formularzom i przyciskom na niej zielone światło, ponieważ tagi HTML są poprawne pod względem składni. Mimo to, z punktu widzenia funkcjonalności i semantyki, witryna ta jest absolutną katastrofą, która całkowicie blokuje użytkowników czytników ekranu i nawigacji klawiaturowej.
AI jako Genialny Asystent
Kryteria WCAG są dobrze znane ze swojej złożoności i z tego, że napisano je w ścisłym żargonie prawniczym i normalizacyjnym. Kiedy programista napotyka ostrzeżenie skanera typu: “Element button nie ma dostępnej nazwy”, może naturalnie nie wiedzieć, jak to naprawić lub dlaczego ma to znaczenie.
Generatywna sztuczna inteligencja doskonale sprawdza się w tym miejscu jako interaktywny tłumacz na prosty język. Może wziąć surowy błąd z narzędzia axe-core z dokumentacją ze speyfikacji WCAG i przekształcić go w dobrze zorganizowane zadanie operacyjne w Jira lub na GitHubie, podzielone na trzy jasne części:
- Co jest nie tak:
“Przycisk z ikoną lupy nie ma etykiety tekstowej.” - Komu to szkodzi:
“Niewidoma osoba korzystająca z czytnika ekranu usłyszy tylko słowo ‘Przycisk’, nie wiedząc, że aktywuje ono funkcję wyszukiwania.” - Jak to naprawić:
“Dodaj atrybut aria-label=”Search” do elementu button.”
Przełom w aplikacjach Single-Page Application (SPA)
Dynamiczne aplikacje zbudowane na frameworkach takich jak Angular, React i Vue historycznie wprawiały w zakłopotanie zautomatyzowane narzędzia, ponieważ treść aktualizuje się tam asynchronicznie bez przeładowania strony. Badanie z 2026 roku przeprowadzone przez zespół Fernández-Navarro wykazało przełom: proces oparty na modelach LLM z powodzeniem usunął 86% błędów dostępności w złożonych aplikacjach w Angularze.
AI zrobiła więcej niż tylko dodała statyczne atrybuty. Przeanalizowała logikę komponentów, dynamicznie wstrzyknęła powiadomienia aria-live (powiadamiając czytniki ekranu o asynchronicznie ładowanych danych) oraz natywnie, na poziomie kodu źródłowego, zarządzała fokusem klawiatury.
Pułapka ALT-Text i “funkcjonalna ślepota”
Zgodnie z raportem WebAIM Million (2026), ponad 25% wszystkich obrazów na czołowych stronach internetowych ma brakujący, wątpliwy lub powtarzający się tekst alternatywny. Aby szybko to załatać, wiele organizacji masowo wdraża standardowe modele wizyjne (MLLM) do generowania tekstu alternatywnego dla całych swoich baz zdjęć.
Prowadzi to do zjawiska znanego jako f*unkcjonalna ślepota.*
W badaniach na Uniwersytecie Illinois (2025/2026) niewidomi użytkownicy czytników ekranu potrafili w ciągu sekund wykryć opisy obrazów wygenerowane przez AI. Dlaczego? Ponieważ podstawowa AI opisuje piksele, a nie cel. Wymienia obiekty mechanicznie – np. “Mężczyzna i kobieta siedzący przy drewnianym stole w pokoju z białymi ścianami” – bez wyrażania intencji autora ani relacji między obiektami. Cały ten wizualny szum przytłaczał użytkowników, powodując, że wielu z nich poddawało się podczas zakupów lub przeglądania stron. Jak zauważył jeden z testerów: “AI opisuje to, co widzi w pikselach; człowiek musi wiedzieć, dlaczego ten obraz znajduje się na stronie.”
Rozwiązanie: AI świadome kontekstu (SmartCaption AI)
Rozwiązaniem jest sztuczna inteligencja świadoma kontekstu (Context-Aware AI). Badania przeprowadzone przez Huynh & Lin (2026) przedstawiły SmartCaption AI, system, który przed zleceniem modelowi LLM wygenerowania opisu najpierw analizuje i podsumowuje tekst otaczający obraz (nagłówki, akapity).
Dzięki osadzeniu modelu wizyjnego w kontekście strony, dokładność i użyteczność opisów wzrosła do 87,18%.
- Bez kontekstu: “Dwóch mężczyzn w garniturach podających sobie ręce w pobliżu okna.”
- Z kontekstem: “Dyrektorzy generalni Firmy X i Firmy Y podpisujący umowę o fuzji.”
Dedykowany RAG w dostępności (Accessibility-RAG)
Wykorzystywanie podstawowych, ogólnodostępnych modeli LLM do przeprowadzania audytów prawnych i technicznych w obszarze dostępności cyfrowej niesie ze sobą krytyczne ryzyko operacyjne. W świetle zaostrzających się regulacji – takich jak European Accessibility Act (EAA) czy norma EN 301 549 – halucynowanie nieistniejących wyłączeń prawnych, zmyślanie kryteriów sukcesu WCAG lub proponowanie błędnych struktur ARIA stwarza bezpośrednie zagrożenie odpowiedzialnością prawną i finansową dla organizacji.
Aby wyeliminować zjawisko halucynacji i zapewnić stałą spójność z aktualnymi wytycznymi W3C, zespoły inżynieryjne wdrażają architekturę Accessibility-RAG (Retrieval-Augmented Generation). Działa ona w oparciu o proces zakotwiczenia (grounding), w którym model generatywny nie odpowiada na podstawie swojej pamięci parametrycznej, lecz tworzy wypowiedź wyłącznie na fundamencie zweryfikowanych fragmentów dokumentacji pozyskanych z zewnętrznej bazy wiedzy.
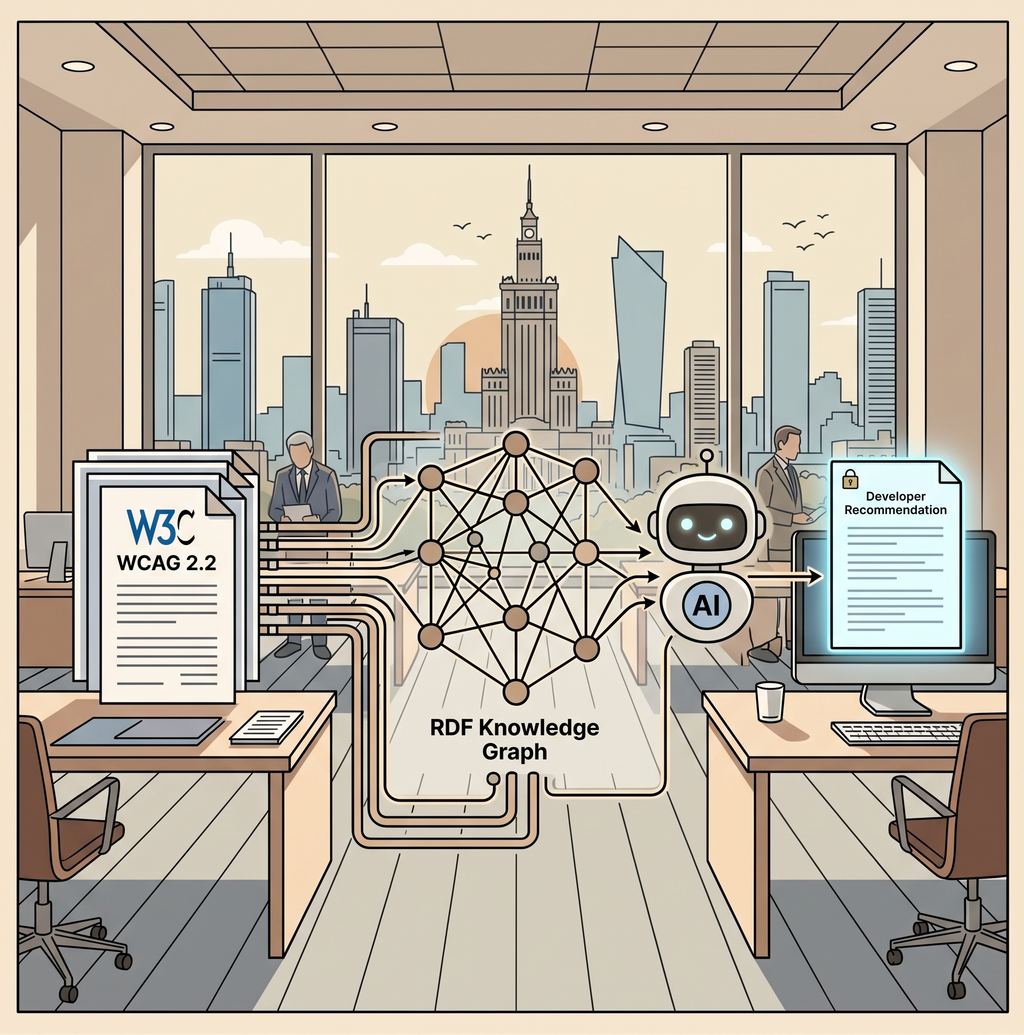
Architektura wiedzy: od naiwnego cięcia (PDF-to-Prompt) do grafów RDF
Tradycyjne wdrożenia RAG często opierają się na standardowym podziale dokumentów (naive chunking), gdzie specyfikacja WCAG 2.2 jest mechanicznie cięta na stałe fragmenty tekstowe (np. po 500 tokenów). W kontekście norm dostępności cyfrowej takie podejście jest niszczące, ponieważ bezpowrotnie zrywa relacje hierarchiczne i semantyczne. Standard WCAG nie jest płaskim tekstem, lecz gęstą siecią powiązań normatywnych:
Zasada (POUR) →Wytyczna → Kryterium Sukcesu (A/AA/AAA) → Technika Obowiązkowa → Technika Doradcza / Wyjątek
Naiwne przecięcie tekstu w przypadkowym miejscu pozbawia model informacji o poziomie zgodności (A vs AAA) lub odcina kryterium od jego oficjalnych wyłączeń, prowadząc do fałszywych alarmów (false positives).
Z tego powodu nowoczesne systemy Accessibility-RAG wykorzystują segmentację uwzględniającą strukturę (structure-aware chunking) oraz Grafy Wiedzy RDF (czemu poświęcono m.in. badania nad modelem G3BG – Graph-Based Block-to-Block Generation). Przechowywanie wiedzy w formie grafowej pozwala silnikowi wyszukiwania (retriever) na podążanie za relacjami między węzłami pojęciowymi (np. Pola formularza Etykiety Kryterium 3.3.2) bez utraty kontekstu prawnego24.
Mierzalne bezpieczeństwo: Triada RAG
Aby zagwarantować, że wewnętrzny system Accessibility-RAG dostarcza niezawodnych wskazówek deweloperom i audytorom, proces jego ewaluacji dekomponuje się na trzy niezależne wymiary składające się na tzw. Triadę RAG (spopularyzowaną przez TruLens RAG Evaluation Framework oraz badania nad LLM-FACETS):
- Wierność (Faithfulness):
Mierzy poziom zakotwiczenia odpowiedzi w wyciągniętym kontekście źródłowym. Odpowiada na pytanie: Czy każda teza postawiona przez AI znajduje 100% pokrycia w dostarczonym fragmencie WCAG? Wskaźnik ten bezpośrednio eliminuje wyhalucynowane techniki i nieistniejące przepisy. - Trafność odpowiedzi (Answer Relevance):
Weryfikuje, czy wygenerowana instrukcja bezpośrednio i precyzyjnie rozwiązuje problem dewelopera (np. naprawę błędu nawigacji klawiaturowej), czy też ucieka w ogólny, bezużyteczny wykład. - Adekwatność kontekstu (Context Relevance):
Ocenia jakość samego silnika wyszukiwania (retrievera). Mierzy stosunek sygnału do szumu, sprawdzając, czy z bazy wiedzy wyciągnięto dokładnie to kryterium sukcesu, które odpowiada problemowi, eliminując nieistotny balast informacyjny.
Wtyki ewaluacyjne uzupełnia się dodatkowo o wskaźniki Context Precision (czy najważniejsze dokumenty znalazły się na samej górze wyników) oraz Context Recall (czy wyszukiwarka odnalazła wszystkie wytyczne niezbędne do sformułowania pełnej odpowiedzi).
Epistemiczna przejrzystość i mechanizmy kontrolne
Sam RAG wymaga dodatkowych obwarowań chroniących przed subtelną błędną interpretacją:
- Wizualizacja niepewności (LogProbs / LLM-FACETS):
Poprzez analizę prawdopodobieństwa logarytmicznego tokenów na poziomie wyjścia modelu (token-level log-probabilities), interfejsy narzędziowe potrafią podświetlać tekst generowany przez AI na pomarańczowo lub czerwono w miejscach, gdzie model wyraża niską pewność statystyczną. Sygnalizuje to ludzkiemu audytorowi konieczność wzmożonej czujności. - Twarde reguły odmowy (Guardrails):
W systemie zaimplementowane są rygorystyczne instrukcje zabraniające modelowi zgadywania lub samowolnej interpretacji luk w prawie. Jeśli zapytanie dewelopera dotyczy niestandardowej interakcji, której baza wiedzy W3C jednoznacznie nie definiuje, model odmawia odpowiedzi i automatycznie przekazuje sprawę ludzkiemu ekspertowi ds. dostępności.
Integracja w potokach CI/CD
Aby zapewnić ciągłość kontroli jakości, potoki Accessibility-RAG są testowane automatycznie w środowiskach programistycznych:
- DeepEval pozwala definiować asercje w testach jednostkowych (w stylu PyTest), blokując scalanie kodu (merge gate) w CI/CD, jeśli wskaźnik Faithfulness spadnie poniżej ustalonego progu jakości.
- Arize Phoenix udostępnia pełny ślad wykonania (tracing via OpenTelemetry), pozwalając inżynierom dokładnie prześledzić, które fragmenty dokumentacji zostały pobrane z bazy dla danego zapytania.
- Promptfoo umożliwia wdrażanie testów adwersaryjnych (red-teaming), badając odporność RAG na próby wprowadzenia go w błąd.
Niebezpieczny audytor
Gdy organizacje próbują całkowicie zastąpić ludzkich ekspertów autonomicznymi modelami sztucznej inteligencji, wpadają w pułapkę tzw. “wyhalucynowanej zgodności” (Hallucinated Compliance). Zjawisko to jest znacznie groźniejsze niż zwykłe przeoczenie błędu przez tradycyjny skaner – stanowi ono trójwymiarowe zagrożenie techniczne, prawne i funkcjonalne:
- Fałszywe poczucie bezpieczeństwa
Model z pełnym przekonaniem generuje raport deklarujący 100% zgodności strony z normami WCAG 2.1 AA lub wytycznymi European Accessibility Act (EAA). W rzeczywistości witryna zawiera krytyczne blokady – takie jak pułapki klawiaturowe (keyboard traps), gubienie fokusu przy nawigacji czy brak powiadomień dla czytników ekranu przy dynamicznej zmianie treści (SPA). AI analizuje czystą składnię kodu, wykazując całkowitą ślepotę na realne doświadczenie użytkownika (User Experience) oraz wytyczne dostępności poznawczej (COGA). - Kreowanie mitycznych wytycznych i nieistniejących reguł (phantom criteria)
Wyhalucynowana zgodność to także generowanie przez AI fikcyjnych wymogów prawnych oraz niezgodnych ze specyfikacją W3C kryteriów sukcesu. Model potrafi zmyślić wyjątki od przepisów albo narzucić deweloperom przestarzałe, szkodliwe strukturyARIA. W efekcie zespoły programistyczne marnują setki godzin na wdrażanie “poprawek” wymyślonych przez model, które w rzeczywistości nie mają oparcia w normach i wprowadzają szum w kodzie. - Destrukcja struktury kodu i regresje
Trzecim wymiarem jest tzw. “efekt domina” przy próbach automatycznej naprawy przez AI. Proponując poprawkę dla jednego lokalnego błędu (np. wstrzyknięcie etykiety do przycisku), model skupia się wyłącznie na odosobnionym elemencie. W konsekwencji potrafi naruszyć strukturę drzewa DOM w całym pliku, zduplikować identyfikatory ID, zepsuć hierarchię nagłówków lub wprowadzić błędy w skryptach JavaScript. Strona zyskuje teoretycznie “poprawny” przycisk, ale cała aplikacja staje się niestabilna lub nieużywalna.
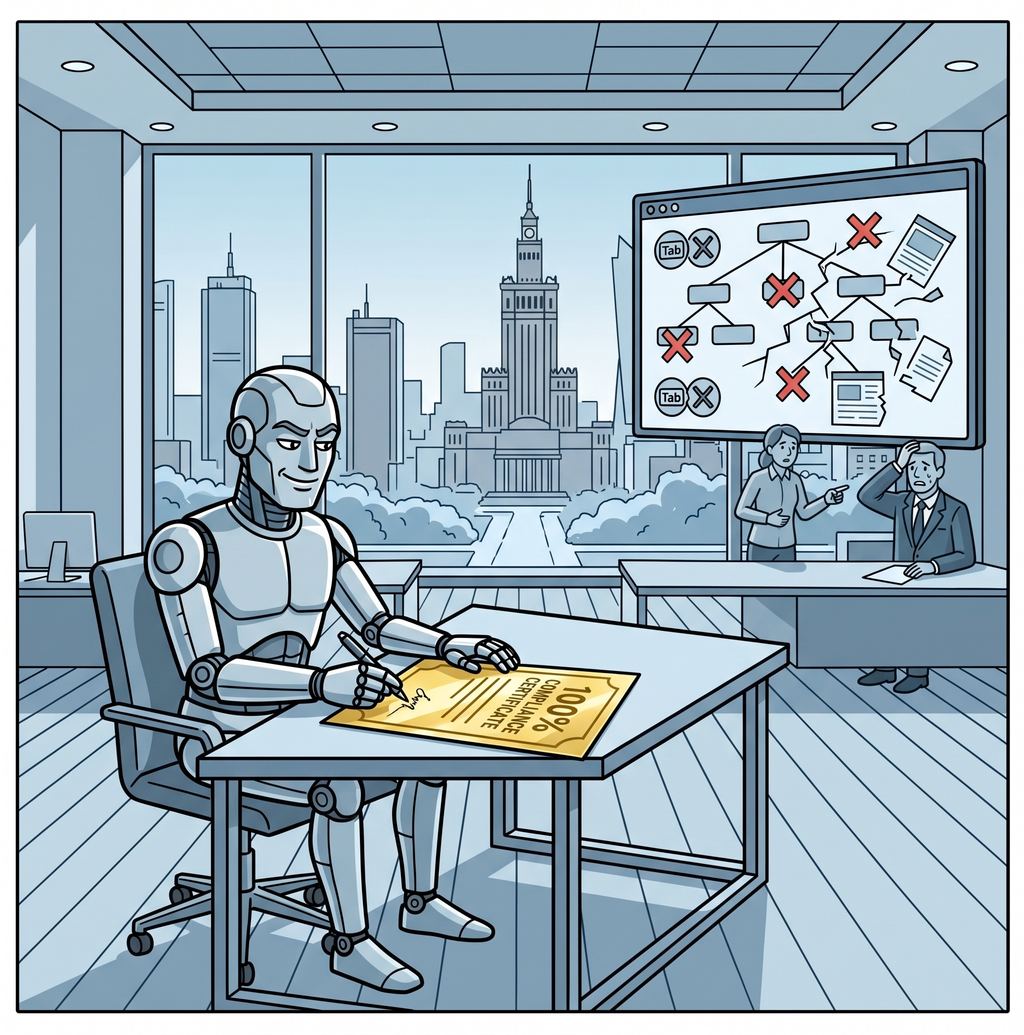
Ryzyko prawne i operacyjne
Badania nad samoweryfikacją raportów audytowych przez popularne modele LLM (takie jak GPT-4o mini czy Gemini Flash) wskazują na ich zatrważająco niską dokładność – na poziomie zaledwie 30% – 34%. Bez udziału wyspecjalizowanych modeli wnioskujących i – co najważniejsze – kontroli ze strony ludzkiego eksperta, bezkrytyczne podpisanie się pod w 100% automatycznym audytem AI wystawia organizację na bezpośrednie ryzyko prawne, sprawiając, że taka “oszczędność” staje się najdroższą drogą na skróty.
Ślepy punkt COGA
Być może największym ograniczeniem jest to, że sztuczna inteligencja nie może oceniać barier poznawczych. Systematic Literature Review (SLR) przedstawiony na Web4All 2026, w którym przeanalizowano 38 badań nad modelami LLM w zakresie dostępności, ujawnił potężny ślepy punkt: modele AI skupiają się niemal w 100% na składni kodu (tagi alt, współczynniki kontrastu, atrybuty lang). Całkowicie ignorują wytyczne dotyczące dostępności poznawczej i edukacyjnej (Cognitive and Learning Disabilities Accessibility – COGA). AI nie potrafi ocenić przeciążenia informacyjnego, złożoności przepływów nawigacyjnych ani płynności językowej i kontekstu emocjonalnego interfejsu.
Podsumowanie: niebezpieczny audytor czy genialny asystent?
Czy sztuczna inteligencja w dostępności cyfrowej to niebezpieczny audytor, czy genialny asystent? Odpowiedź brzmi: tak, jest jednym i drugim – a to, którą twarz ukaże, zależy od tego, czy pozwolimy jej działać samodzielnie.
W rękach doświadczonego zespołu AI sprawdza się jako genialny asystent. Przejmuje nudną, powtarzalną pracę: wstępną kategoryzację błędów (triage), tłumaczenie zawiłego żargonu WCAG na zrozumiałe zadania w Jierze czy generowanie poprawnych kontekstowo szkiców kodu. Uwalnia ludzkiego eksperta od rutyny, przesuwając go wyżej w łańcuchu wartości i dając mu przestrzeń na głęboką analizę semantyczną oraz empatyczne projektowanie.
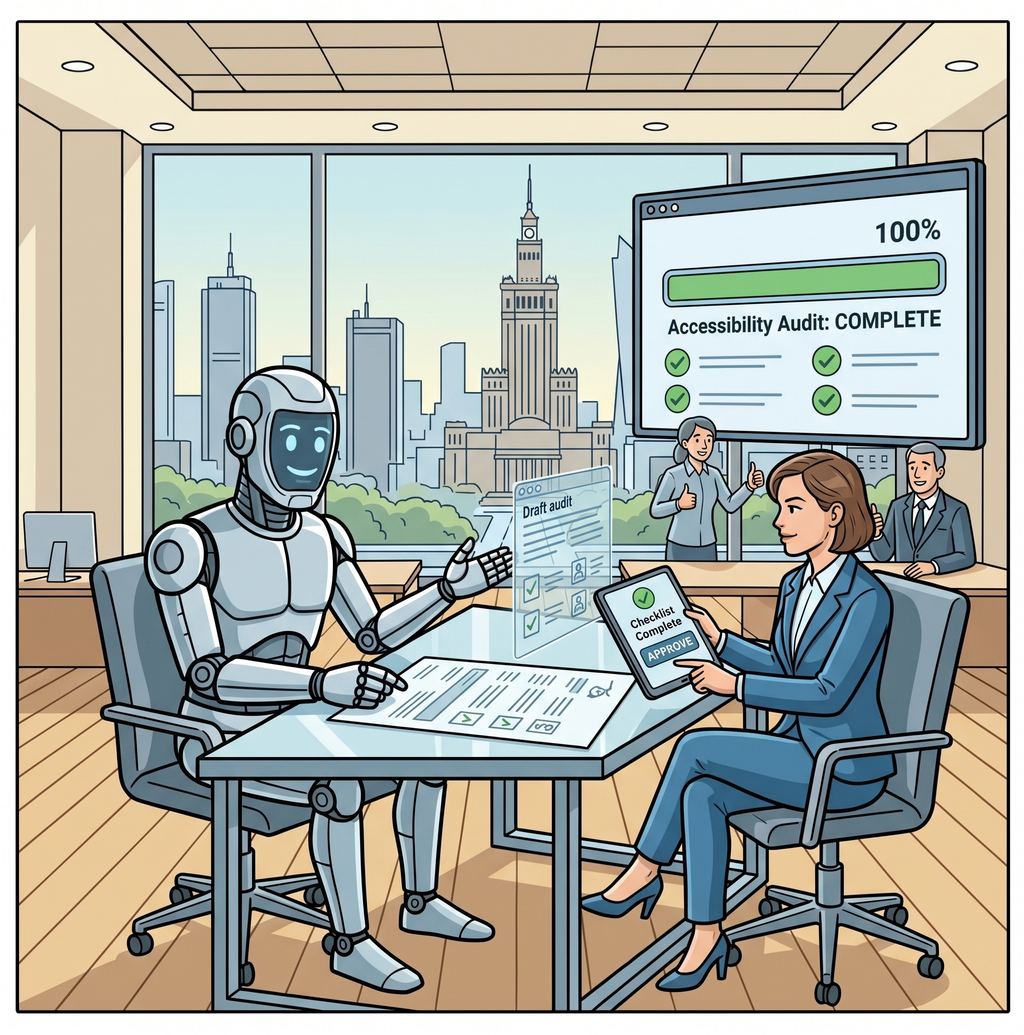
Jednak to samo AI, pozostawione bez nadzoru i traktowane jako autonomiczny sędzia, natychmiast zmienia się w niebezpiecznego audytora. Generuje fałszywe certyfikaty zgodności, halucynuje nieistniejące przepisy prawne, niszczy strukturę DOM podczas prób automatycznych napraw i wykazuje całkowitą ślepotę na dostępność poznawczą (COGA) oraz realne wykluczenie użytkowników.
Właśnie dlatego model Human-in-the-Loop nie jest przejściowym kompromisem, lecz fundamentem bezpiecznej dostępności. Sztuczna inteligencja może dostarczyć świetny szkic, ale to człowiek wnosi empatię, zrozumienie kontekstu i odpowiedzialność prawną.
Ostatecznie bowiem jakość dostępności mierzy się doświadczeniem człowieka, a nie brakiem czerwonych błędów w konsoli.
Pytania
1. Czy nakładki dostępnościowe (overlays) oparte na AI rozwiązują problem?
Nie. Te widżety działają tylko jako javascriptowy plaster na zepsuty DOM. Badania pokazują, że użytkownicy czytników ekranu często je wyłączają, ponieważ kłócą się z ustawieniami ich własnych technologii wspomagających. Bezpieczna, skuteczna sztuczna inteligencja działa na poziomie kodu źródłowego w procesie CI/CD, a nie jako doklejony skrypt.
2. Czy możemy legalnie zatwierdzić audyt wygenerowany w całości przez AI?
Nie. Podpisanie audytu w 100% wygenerowanego przez AI niesie ze sobą ogromne ryzyko prawne i finansowe na mocy przepisów takich jak EAA. Ponieważ modele wykazują tylko 30% – 34% dokładności przy autoweryfikacji i występuje duże ryzyko wyhalucynowanej zgodności, AI powinna być używana tylko do opracowania wstępnego triażu. Odpowiedzialność prawna i ostateczny podpis muszą zawsze pochodzić od ludzkiego eksperta.
3. Jak przekonać zarząd, że “w 100% zielony pasek” w automatycznym narzędziu nie wystarczy?
Należy odwołać się do metodologii, z której wynikają te liczby (Deque Systems 2021 i badanie GDS 2017). Tradycyjne skanery testują zaledwie około 25% kryteriów WCAG-A. Zielony pasek oznacza jedynie, że kod HTML nie ma rażących błędów składniowych; nie oznacza to wcale, że niewidomy użytkownik lub użytkownik z niepełnosprawnością ruchową może faktycznie sfinalizować zakup na danej stronie.
4. Biorąc pod uwagę problemy z “funkcjonalną ślepotą”, czy używanie AI do tekstu ALT ma w ogóle sens?
Tak, ale musi zmienić się architektura. Zastosowanie surowego modelu AI do obrazów generuje szum. Jednak wykorzystanie podejścia uwzględniającego kontekst (Context-Aware), takiego jak SmartCaption AI, które karmi model otaczającym tekstem strony, podnosi dokładność powyżej 87%. W przypadku ogromnych katalogów w branży e-commerce stanowi to gigantyczną oszczędność czasu, pod warunkiem, że człowiek pozostaje włączony w proces kontroli jakości. Zamiast SmartCaption można napisać prompt lub stworzyć agenta, które pomogą nam z kontekstem i prawidłowym pisaniem ALT-text.
5. Czy AI potrafi oceniać dostępność poznawczą (COGA) albo użyteczność dla użytkowników neuroróżnorodnych?
Nie. Systematyczne przeglądy literatury pokazują, że modele LLM skupiają się niemal wyłącznie na mechanicznej składni HTML (np. atrybutach ARIA, tagach obrazów i kontraście) i praktycznie całkowicie pomijają wytyczne COGA. AI nie potrafi dokładnie ocenić przewidywalności układu interfejsu, natłoku informacji czy zmęczenia czytaniem. Chociaż AI może pomóc przepisać skomplikowane teksty na prosty język, ocena dostępności poznawczej nadal wymaga ludzkich testów UX i bezpośrednich opinii użytkowników.
6. Jak zespoły programistyczne powinny wdrażać AI do codziennej pracy bez ryzyka pisania złego kodu ARIA?
Wykorzystuj sztuczną inteligencję na etapie środowiska IDE lub podczas procedury Pull Request (PR), nigdy w trybie autonomicznej automatycznej naprawy. Integruj AI poprzez serwery Model Context Protocol (MCP) lub asystentów PR (takich jak AccessGuru lub WebYes) bezpośrednio w środowisku programistycznym. Wtedy AI działa jako drugi pilot piszący szkice poprawek w kodzie oraz objaśniający błędy prostym językiem, jednak każdy PR przed zatwierdzeniem musi przejść weryfikację przez automatyczne lintery (np. axe-core) oraz obowiązkową ludzką inspekcję kodu.
7. Czy użycie LLM do naprawy dostępności faktycznie opłaca się w porównaniu do ludzkich audytów?
Tak, ale wyłącznie w celach klasyfikacji problemów (triaż) i doradzania programistom. Z badań wykorzystania tokenów w LLM wynika, że przepuszczanie nieograniczonych pętli analiz na pełnych drzewach DOM pochłania znaczne koszty API (“niewidzialne tokeny”), a jednocześnie sztuczna inteligencja jest w stanie samodzielnie rozwiązać mniej niż 26% skomplikowanych kłopotów z kodem. Największy zwrot z inwestycji zapewnia zatrudnienie AI do tłumaczenia zawiłych błędów WCAG na praktyczne zadania w systemie Jira. Daje to oszczędność całych godzin pracy programistów w porównaniu z próbami w pełni zautomatyzowania całego przebiegu audytu.
8. Czy powinniśmy pozwalać sztucznej inteligencji na zautomatyzowane generowanie tekstu ALT dla wszystkich obrazów na całej naszej platformie?
Nie. Automatyczne i bezmyślne “wypuszczenie” modeli wizualnych na całą stronę często skutkuje tym, że bezużytecznymi i długimi opisami zostają oklejone elementy czysto dekoracyjne, dystanse (spacers) czy puste elementy graficzne w tle. Powoduje to powstawanie skrajnego szumu w czytnikach ekranu, niezwykle irytującego dla użytkowników. Przewody procesowe AI (pipelines) muszą być obwarowane zasadami identyfikującymi obrazy dekoracyjne, nakazującymi przypisanie im pustego atrybutu alt="" (lub aria-hidden="true") zamiast wymuszania opisywania każdego detalu na pikselach.
9. Jeżeli chcielibyśmy stworzyć w firmie wewnętrznego asystenta WCAG bazującego na AI, to jaką architekturę powinniśmy wybrać?
Zbuduj rozwiązanie Accessibility-RAG oparte na rzetelnych, oficjalnych specyfikacjach W3C, a nie po prostu na “czystym” LLM. Zamiast prostego “cięcia PDF-a”, postaw na architekturę opartą na grafach (RDF) lub ustrukturyzowane wyszukiwanie informacji, by zachować hierarchiczną strukturę kryteriów i technik WCAG. Wprowadź restrykcyjne zabezpieczenia (guardrails), które zmuszają model do wycofania się z odpowiedzi, gdy wytyczne WCAG są niejednoznaczne, i używaj systemów wielostopniowych albo wnioskujących (reasoning models), by wyłapywać próby halucynowania fałszywych wniosków dotyczących zgodności.
Źródła
Artykuły naukowe i publikacje
- [[2507.19549] AccessGuru: Leveraging LLMs to Detect and Correct Web Accessibility Violations in HTML Code – arXiv](https://arxiv.org/abs/2507.19549)
- [[2605.13873] Large Language Models for Web Accessibility: A Systematic Literature Review](https://arxiv.org/abs/2605.13873)
- A graph-based approach to closed-domain natural language generation
- Agentic Web Accessibility Auditing: A Criterion-Specific Framework for Translating WCAG Requirements into Assessments – arXiv
- Accessible Web Content Generation Using LLMs: An Empirical Study on Prompting Strategies and Template-Guided Remediation – IEEE Latin America Transactions
- Finetune-RAG: Fine-Tuning Language Models to Resist Hallucination in Retrieval-Augmented Generation – arXiv
- Invisible Tokens, Visible Bills: The Urgent Need to Audit Hidden Operations in Opaque LLM Services – OpenReview
- Large Language Models for Web Accessibility: A Systematic Literature Review – arXiv
- Leveraging Large Language Models for Sustainable and Inclusive Web Accessibility – MDPI
- Leveraging LLMs to Detect and Correct Web Accessibility Violations in HTML Code – arXiv
- LLM Based Web Accessibility Repair: An Empirical Study of Detection, Remediation, and Cost – arXiv
- LLM-FACETS: A Privacy-Preserving Framework for Evaluating LLM Transparency and Accountability – arXiv
- Towards Scalable Web Accessibility Audit with MLLMs as Copilots – arXiv
Raporty, przewodniki i blogi branżowe
- 6 Best AI Accessibility Testing Tools in 2026 (Compared) – WebYes
- Accessibility Archives – Page 2 of 6 – Silktide
- Alt Text Best Practices 2025: Complete Guide + AI-Powered Generator – AllAccessible Blog
- Automated Accessibility Testing: What It Catches and What It Misses – TestParty
- Automated accessibility testing: A complete guide for QA teams – Tricentis
- Automated testing – DWP Accessibility Manual
- Automated Testing Identifies 57% Digital Accessibility – Deque Systems
- Blog – Page 3 of 9 – Silktide
- Screen Reader Users Can Tell When You Use AI for Alt Text – Silktide
- The Automated Accessibility Coverage Report – Deque
- Why Automated Accessibility Testing Tools Miss So Much – Applause
Materiały branżowe, RAG i fora dyskusyjne
- 9 Best RAG Evaluation Tools for September 2026 – TestMu AI
- A4Q Syllabus Certified Professional Digital Accessibility
- AI Summary FAQ – Cludo Help Center
- Best RAG Chatbot 2026: Top 5 Platforms Compared – Heeya
- Have you built any GPT Agents for testing? – Ministry of Testing
Materiały dodatkowe
- A guide to WCAG web accessibility – Hicron Blog
- WCAG Accessibility Checklist and Technical Implementation – Hicron Blog

Emilia Krzemińska-Komenda
Emilia to doświadczona inżynierka QA w Hicron Software, łącząca w swojej pracy analityczny umysł testera z pasją do automatyzacji. Mocno wierzy, że technologia, w tym sztuczna inteligencja, powinna służyć ludziom, dlatego aktywnie rozwija swoją wiedzę w kierunku testowania AI oraz dostępności cyfrowej. Wierzy, że testowanie to droga do tworzenia lepszych i bardziej inkluzywnych produktów. |
Bardzo ciekawy tekst. Sam często zastanawiałem się nad rzetelnością automatów. Jestem ciekaw, jak w przyszłości pogodzić AI z realną oceną człowieka.