
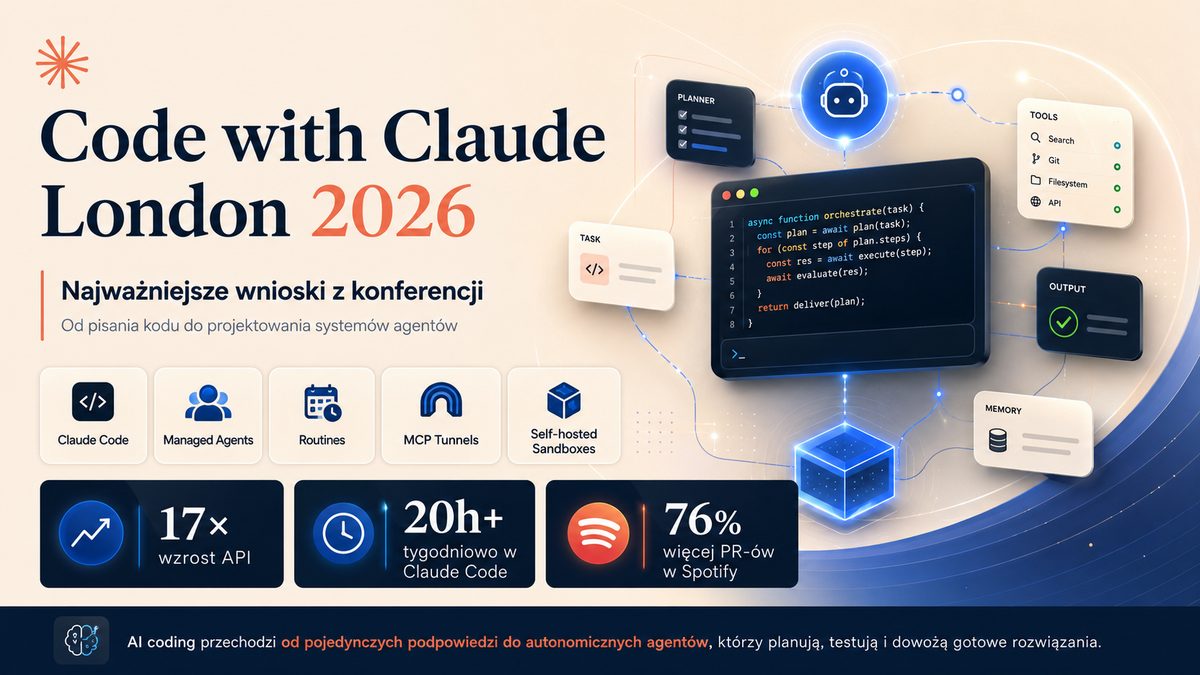
Code with Claude London 2026
Co z tego wynika dla inżynierów testów?
Niniejszy materiał powstał na podstawie transkryptu konferencji Code with Claude London 2026 – pierwszego europejskiego wydania tego wydarzenia Anthropic. Wybrane zostały wątki mające bezpośrednie przełożenie na pracę inżynierów testów, ze szczególnym uwzględnieniem osób automatyzujących testy i piszących kod.
📡 Kontekst: co to za konferencja i dlaczego ma znaczenie
Code with Claude to coroczne wydarzenie Anthropic dla deweloperów budujących na Claude API i Claude Code. Edycja londyńska 2026 była pierwszą poza San Francisco – wyraźny sygnał, że Anthropic traktuje rynek europejski poważnie.
Główne przesłanie całego dnia:
„Możliwości modeli rosną eksponencjalnie. Większość organizacji adoptuje AI liniowo. Rosnąca luka między tym, co AI może, a tym, co faktycznie robi – to wasza szansa.”
— Boris Cherney, Head of Claude Code, Anthropic
Dla testerów automatyzujących: to nie jest czas na „sprawdzę za rok, jak się ustabilizuje”. Narzędzia, które pokazano, są dostępne dzisiaj.
🧠 Modele i task horizon – co to oznacza dla testów
Lisa Kaplan (Research PM, Anthropic) przedstawiła koncepcję task horizon – jak długo agent może pracować, nie gubiąc kontekstu:
Opus 4.7 – co nowego dla testowania i weryfikacji
- Wykrywa własne błędy logiczne na etapie planowania – zanim zacznie pisać kod (case Intuit).
- Kończy zaległy backlog z gotowymi-do-merge PR-ami po przebudzeniu (Opus 4.7 + routines).
- Rozwiązał 3× więcej produkcyjnych zadań inżynierskich niż poprzedni model (benchmark Rakuten).
Scaffolding (pętle, instrukcje, narzędzia wokół modelu): im mądrzejszy model, tym bardziej rozbudowany scaffolding może go spowalniać. Inteligentniejsze modele radzą sobie lepiej z generycznymi prymitywami (system plików, sandbox) niż z nadmiernie szczegółowymi instrukcjami.
✅ Weryfikacja – kluczowy koncept dla QA i test inżynierów
Boris Cherney wielokrotnie wracał do jednego słowa: verification. Demo Claude Code pokazało to w praktyce:
- Claude implementuje refund flow: idempotency, multi-currency, audit logging.
- Otwiera aplikację w przeglądarce i sam wyzwala test flow.
- Wykrywa błąd: modal zamyka się przed pojawieniem toastu (race condition).
- Śledzi przyczynę do optimistic update – naprawia i ponownie weryfikuje przed oznaczeniem zadania jako gotowe.
„Jeśli Claude może sprawdzić swoją pracę, możesz go puścić samego – i wrócić do gotowego wyniku.”
Dla inżyniera testów to fundamentalna zmiana: agent nie kończy pracy po zapisaniu pliku – kończy po potwierdzeniu, że działa. Test jest częścią flow, nie oddzielną fazą.
Implikacje praktyczne:
- Utrzymuj uruchamialny test suite, który agent może wywołać w pętli.
- E2E smoke testy w lokalnym środowisku dają agentowi pętlę weryfikacyjną bez czekania na CI.
- Im szybszy feedback z testów, tym szybsza i tańsza autonomiczna praca agenta.
⚙️ Claude Code – funkcje kluczowe dla test/QA inżynierów
Ralph Ramos (Technical Staff, Anthropic) zaprezentował nowe funkcje Claude Code. Poniżej te, które mają największe znaczenie dla osób automatyzujących testy.
CI Autofix – naprawiacz flaky testów
Rutyna nasłuchuje na zdarzenia PR i proaktywnie naprawia:
- Flaky testy CI – diagnozuje przyczynę (np. network timeout, znany infra issue) i retry lub naprawia root cause.
- Komentarze z code review – adresuje uwagi automatycznie.
- Konflikty merge – auto-rebase.
W codebase samego Claude Code agent jest skonfigurowany, żeby naprawiać root cause, nie robić pustego retry. Engineer nigdy nie zobaczy czerwonego X’a – zanim to zrobi, agent już naprawił.
Ultrareview – multi-agentowy code review
Każdy PR może być automatycznie sprawdzony przez zespół agentów, gdzie każdy sprawdza inny wymiar: błędy, bugi, podatności, błędy logiczne. Faza 2 konfrontuje znaleziska z faktycznym kodem, eliminując false-positive. Uruchamiasz ręcznie lub podpinasz do GitHub app – każdy nowy PR dostaje review automatycznie.
/ultrareview
Security Scan – overnight vulnerability scanner
Skanuje cały codebase w nocy, rankuje podatności według severity i pozwala od razu zlecić Claude Code naprawę każdej z nich. Istotne dla QA w regulated domains (healthcare, fintech).
Routines – zautomatyzowane triggery zadań testowych
Routines to wyższy poziom abstrakcji nad promptem – „higher order prompt”, jak to opisał Boris Cherney. Konfigurujesz agenta, który uruchamia się:
np. codziennie o 8:00 – sprawdź nowe issues i zrób triage
nowy PR → review + smoke tests; nowe issue → zacznij implementację
dowolny zewnętrzny system (Jira, PagerDuty) może wyzwolić agenta
Routines działają na zdalnym compute – komputer nie musi być włączony.
Auto Mode – koniec z niepotrzebnymi permission prompts
Auto mode sprawia, że Claude samodzielnie ocenia, czy akcja jest destrukcyjna lub wygląda jak prompt injection. Jeśli nie – wykonuje bez pytania. Jeśli tak – szuka alternatywnej ścieżki. Dopiero gdy nie ma wyjścia, pyta użytkownika. Wynik: długie sesje automatyzacji nie blokują się na trywialnych permission prompt’ach.
Worktrees – równoległe sesje na tym samym repo
Wbudowane wsparcie dla git worktrees: każda sesja Claude Code dostaje izolowaną kopię repo w osobnym podkatalogu. Wiele agentów może pracować równolegle nad różnymi featurami lub bugami bez wzajemnego nadpisywania plików.
claude –worktree
Auto Memory – kontekst między sesjami
Claude automatycznie notuje wybory architektoniczne, styl kodu, debugging insights – i ładuje je przy kolejnej sesji. Pliki memory nie wychodzą poza lokalną maszynę i nie trafiają do GitHub. Możesz audytować:
📊 Evals – nowe „testy” dla inżynierów AI
Lisa Kaplan powiedziała wprost: evals i prototypy produktowe to jedyne narzędzia, dzięki którym zauważysz, że eksponencjal przesunął się pod tobą.
Dla inżyniera testów to naturalne pole pracy – tworzenie evaluations dla agentów AI to de facto test automation na innym poziomie abstrakcji:
- Zautomatyzuj evals – żeby sprawdzanie nowych wersji modelu było bezbolesne i szybkie.
- Testuj modele hands-on – „poczuj” nowe możliwości, zanim benchmark je pokaże.
- Trudniejsze evals – w miarę jak model się poprawia, musisz podbijać poprzeczkę, inaczej wszystko zawsze będzie zielone i stracisz sygnał.
- Traktuj upgrade modelu jak okazję biznesową, nie ryzyko.
Spotify wbudował to w swojej kulturze: instrumentacja wszystkich PR-ów i infrastruktury daje metryki, które pokazują realny wpływ zmian narzędziowych na produktywność inżynierów.
🎵 Case Study: Spotify – inżynieria testów w skali floty
Niklas Gustafsson (Engineering Director, Spotify) pokazał, jak 3000-osobowy org deweloperski zarządza kodem przy 4500 deploymentach dziennie.
Fleet Shift + Honk – automatyczne migracje kodu
Narzędzie Honk (Claude Agent SDK + Kubernetes pod) przyjmuje opis migracji w naturalnym języku i przeprowadza ją na tysiącach repozytoriów równolegle. Każdy agent ma dostęp do narzędzi weryfikacyjnych – buduje kod w CI, testuje na wielu OS-ach. Ostatnia migracja Javy: 3 dni zamiast tygodni.
„Kod jest teraz znacznie mniejszym bottleneckiem. Teraz bottleneck to decyzje ludzkie – co budować, które pomysły walidować.”
Wnioski dla test inżynierów z przypadku Spotify
- Standardyzacja kodu = lepsze agenty. Spotify obserwuje gorsze wyniki Claude w rozdrobnionych codebases. Jednolity stack i design patterns to guardrails dla agenta.
- Lint = natychmiastowy feedback dla agenta. Kiedy Claude używa złego wzorca, reguły lint go korygują w pętli – bez udziału człowieka.
- Human judgment tam, gdzie naprawdę potrzebny. 76% więcej PR-ów = trzeba zdecydować, które sprawdzać ręcznie. Spotify już auto-merge’uje część PR-ów bez human review.
- Dobre testy = autonomia agenta. Agent testuje własną pracę tylko wtedy, gdy test suite jest szybki i deterministyczny.
🚀 Case Study: Delivery Hero – autonomiczny pipeline PR
HeroGen – agent bierze Jira ticket lub GitHub issue i prowadzi go do production-ready pull request. Wdrożony Q1 2026, zbudowany w Q3/Q4 2025 z myślą o możliwościach przyszłych modeli (a nie ówczesnych).
„Patrzyliśmy, dokąd zmierza trajektoria i zdecydowaliśmy się zbudować coś, czego modele jeszcze nie udźwigną w pełni – ale dziś już dźwigają.”
— Ulrich Schäfer, VP Tech Foundations, Delivery Hero
🔧 Case Study: Lovable – self-healing i metryka is_stuck
CEO Lovable przedstawił podejście do jakości na platformie z 50 mln projektów i 200 tys. nowymi dziennie. Interesująca metodologia mierzenia i naprawiania failure modes na skali.
Metryka is_stuck
Użytkownik jest „zakorkowany” gdy:
- pyta o to samo 3 razy z rzędu (np. „napraw to”, „napraw to”, „napraw to”),
- skarży się na implementację,
- pyta i wychodzi bez kontynuacji.
Metryka wykrywana lightweight classifier-em. Trzy kategorie problemów: rozwiązywalny przez inny prompt / leżący po stronie platformy (łatwy fix) / leżący po stronie platformy (duże nakłady).
Lovable Overflow – system wiedzy o błędach
Corpus opisów problemów + rozwiązań. Agent przeszukuje go przed odpowiedzią i dosyła releventną wiedzę do kontekstu. Wiedza ma success ratio – nieaktualna jest automatycznie pruned.
Vent Tool – agent raportuje własne frustracje
Agent ma narzędzie, którego używa gdy: brakuje narzędzi, dokumentacja jest niespójna, platforma zachowuje się nieoczekiwanie, powtarzające się błędy wynikają z ograniczeń środowiska. Wiadomość trafia do Slack → inny agent deduplikuje i otwiera PR → engineer klika approve/reject. ~50% PR-ów jest mergowanych. Kilkukrotnie narzędzie wykryło incydent produkcyjny szybciej niż systemy monitoringowe.
Wniosek dla QA: agent może być pierwszą linią wykrywania problemów środowiskowych. Warto dawać modelom narzędzia do raportowania – nie tylko do działania.
🤝 Claude Managed Agents – dla budujących własnych agentów testowych
Jeśli budujesz własny system agentowy (agent do automatyzacji testów, triage defektów, generowania przypadków testowych), Cloud Managed Agents daje gotową infrastrukturę:
Agent uruchamia kod na Twojej infrastrukturze (Cloudflare, Daytona, Modal, Vercel)
Bezpieczny dostęp do prywatnych MCP serwerów bez ekspozycji przez internet
Flotilla agentów z własnymi context windows deleguje wyspecjalizowaną pracę
Definiujesz rubric/cele – agent iteruje aż je spełni
Agent analizuje tysiące poprzednich sesji i poprawia własne memories
Pełna obserwowalność każdej sesji w real time
Advisor Strategy – jakość Opus w cenie Sonnet
Mały model (Haiku/Sonnet) wykonuje, duży (Opus) radzi gdy mały potrzebuje pomocy. EVE Legal uzyskało jakość frontier modelu przy 5× niższych kosztach. Dobry wzorzec dla agentów CI działających przy dużym wolumenie.
🎯 Najważniejsze wnioski dla inżynierów automatyzacji testów
- Verification jest rdzeniem nowego QA. Agent sprawdzający własną pracę (browser, test suite, lint) redukuje potrzebę ręcznej weryfikacji. Twój test suite to paliwo dla pętli weryfikacyjnej agenta – inwestuj w jego szybkość i stabilność.
- CI Autofix eliminuje toil z utrzymania pipeline’ów. Flaky testy, konflikty merge, komentarze review – agent może to wszystko obsłużyć zanim engineer to zobaczy.
- Evals to Twoja nowa specjalizacja. Budowanie evaluacji dla agentów AI to naturalny next step dla inżynierów testów. Kto umie projektować dobre evals, ten będzie mierzył i kierował jakością AI systemów.
- Standardyzacja codebase = lepsze wyniki agentów. Konsekwentne wzorce, lint rules i szybkie testy tworzą guardrails, w których agenci pracują efektywniej.
- Routines = scheduled test runs na sterydach. Konfiguruj agentów reagujących na eventy (nowy PR, nowe issue, harmonogram) bez ręcznego triggerowania.
- Buduj pod następny model. Delivery Hero zbudowało HeroGen, gdy Opus 4.7 jeszcze nie istniał. Dziś system działa. Jeśli budujesz teraz, projektuj architekturę na modele, które dopiero wyjdą.
- Human judgment – gdzie naprawdę potrzebny. Nie review’uj wszystkiego ręcznie. Zdecyduj, które PR-y i testy wymagają ludzkiego oka, a które mogą być automatycznie zaakceptowane.
Materiał przygotowany z perspektywy inżynierów testów i automatyzacji testów.